Wyszukiwarka tekstowa w Django oparta na PostgreSQL
Od __icontains do indeksu trigramowego GIN. Jak w Solvbocie zbudowaliśmy wyszukiwarkę, która na „rej krow gosp” znajduje Sąd Rejonowy dla Krakowa-Krowodrzy, XV Wydział Gospodarczy.
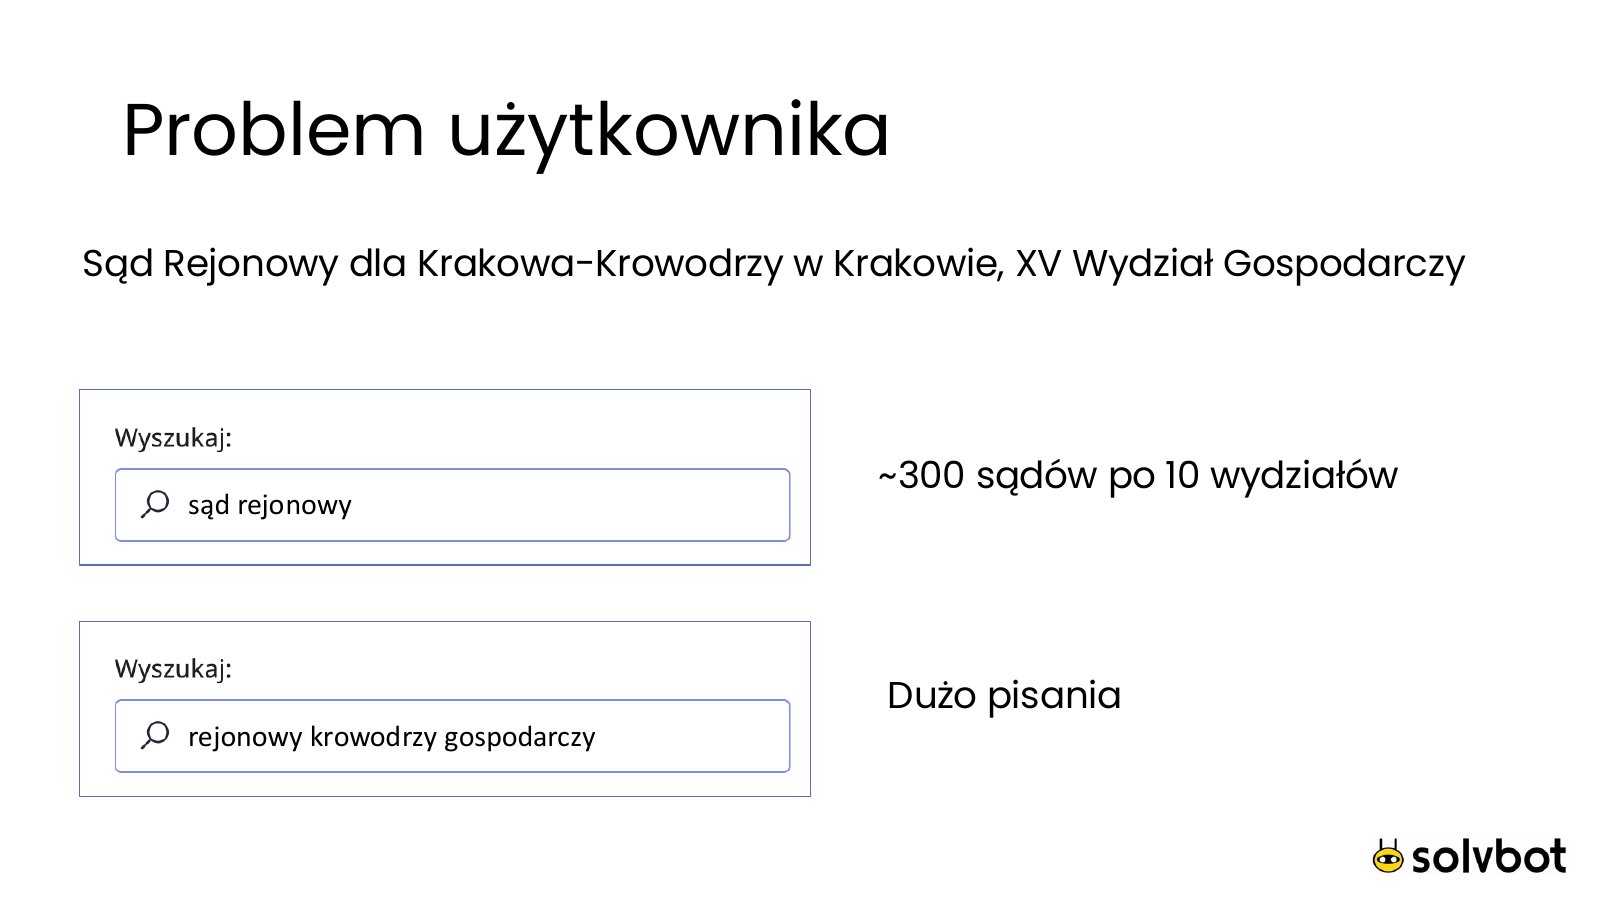
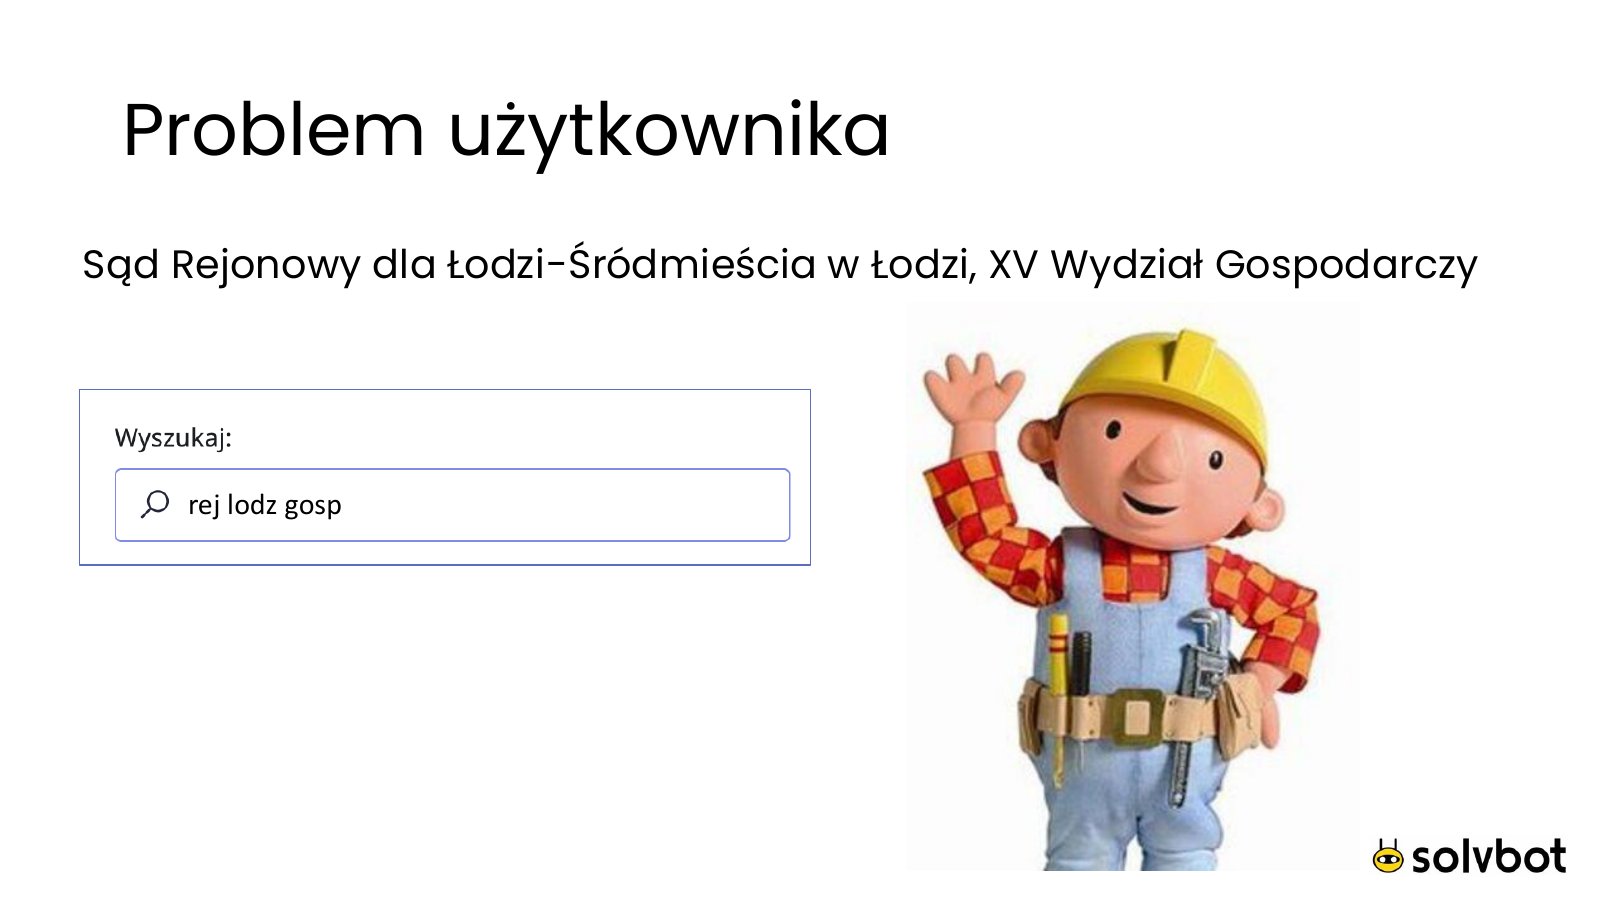
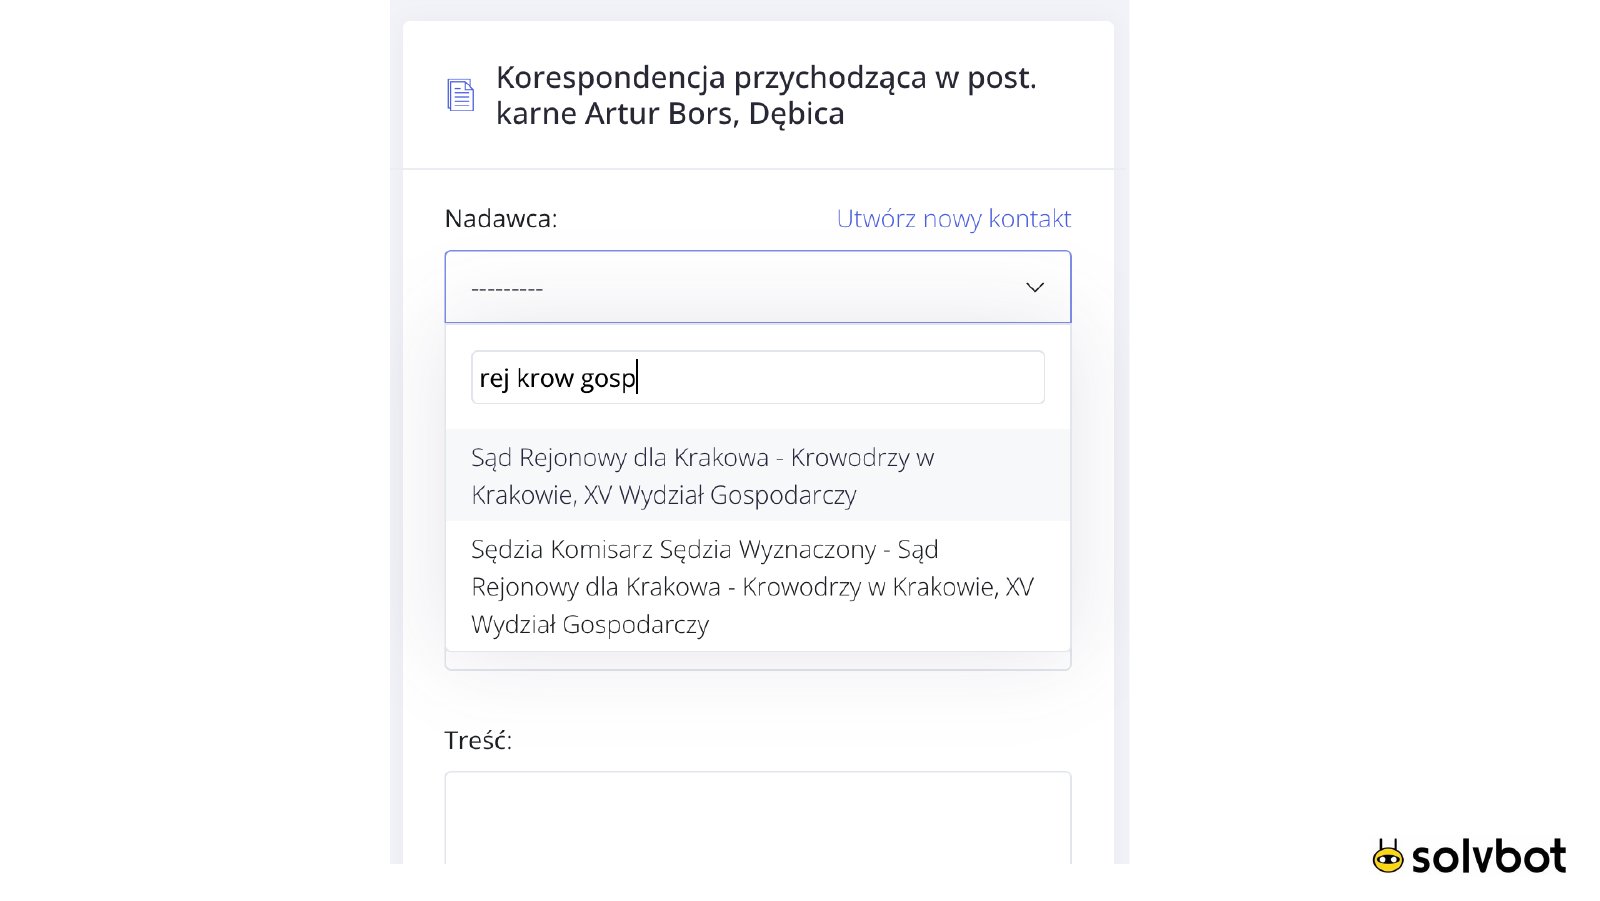
W Solvbocie (dziś Infino Legal) poza treścią dokumentów użytkownicy szukają nazw: sądów, instytucji, osób, tytułów dokumentów i zadań. Sądów jest około 300, po około 10 wydziałów, a nikt nie chce wpisywać „Sąd Rejonowy dla Łodzi-Śródmieścia w Łodzi, XV Wydział Gospodarczy”. Chcą wpisać „rej lodz gosp”. Do tego wyszukiwarka podpowiada wyniki praktycznie w każdym polu wyszukiwania i odpala się przy każdym naciśnięciu klawisza, więc musi być szybka.
Dlaczego nie wystarczy __icontains
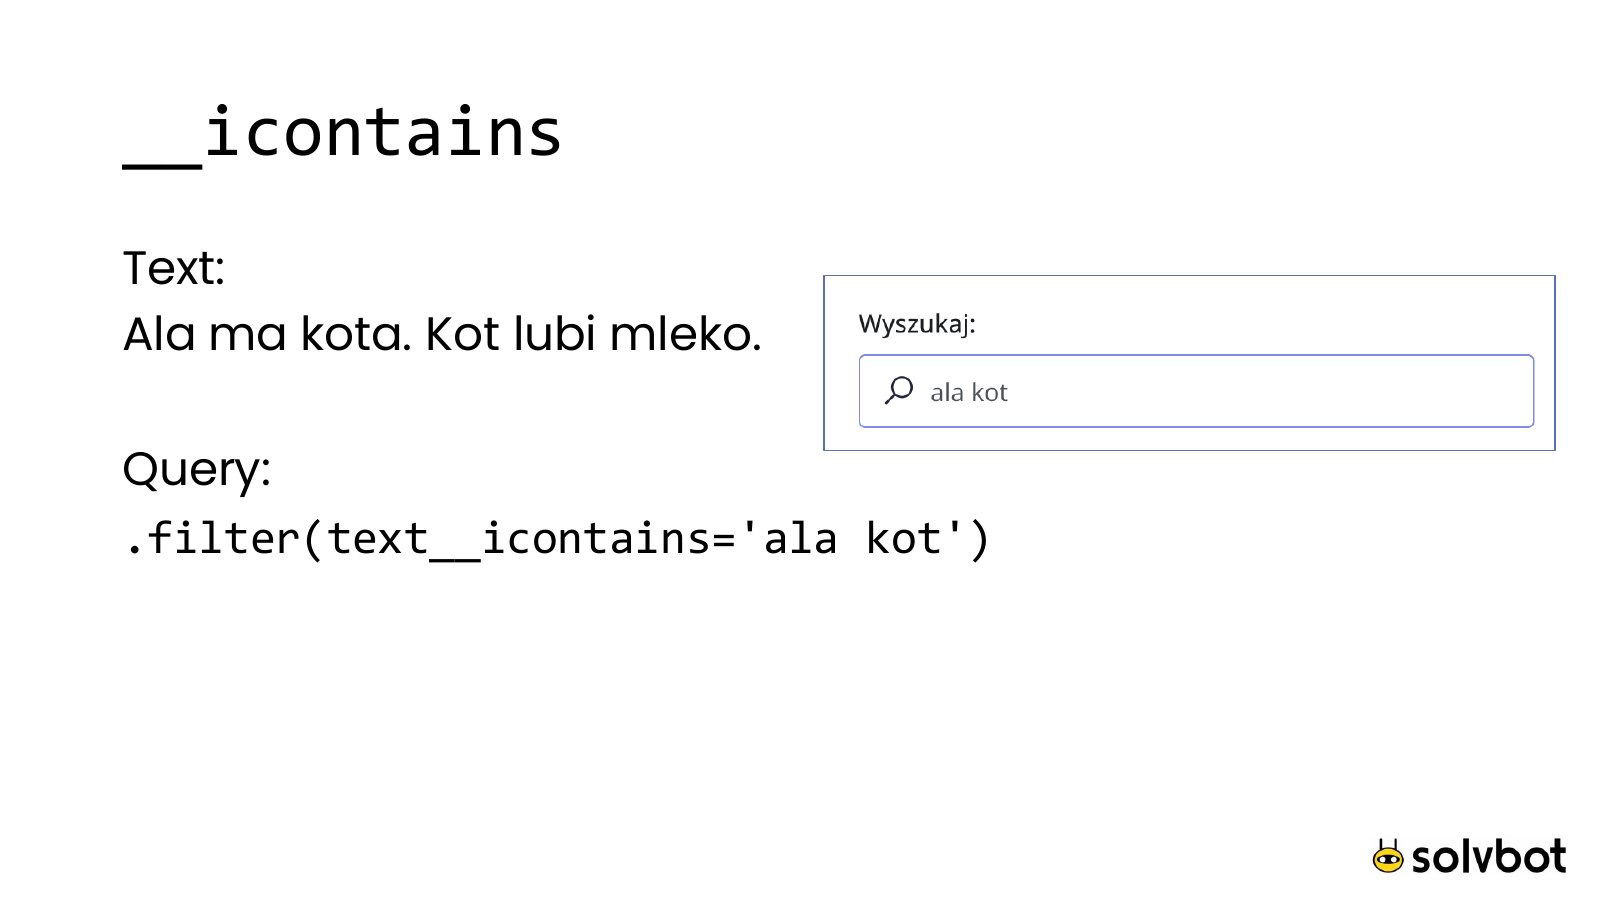
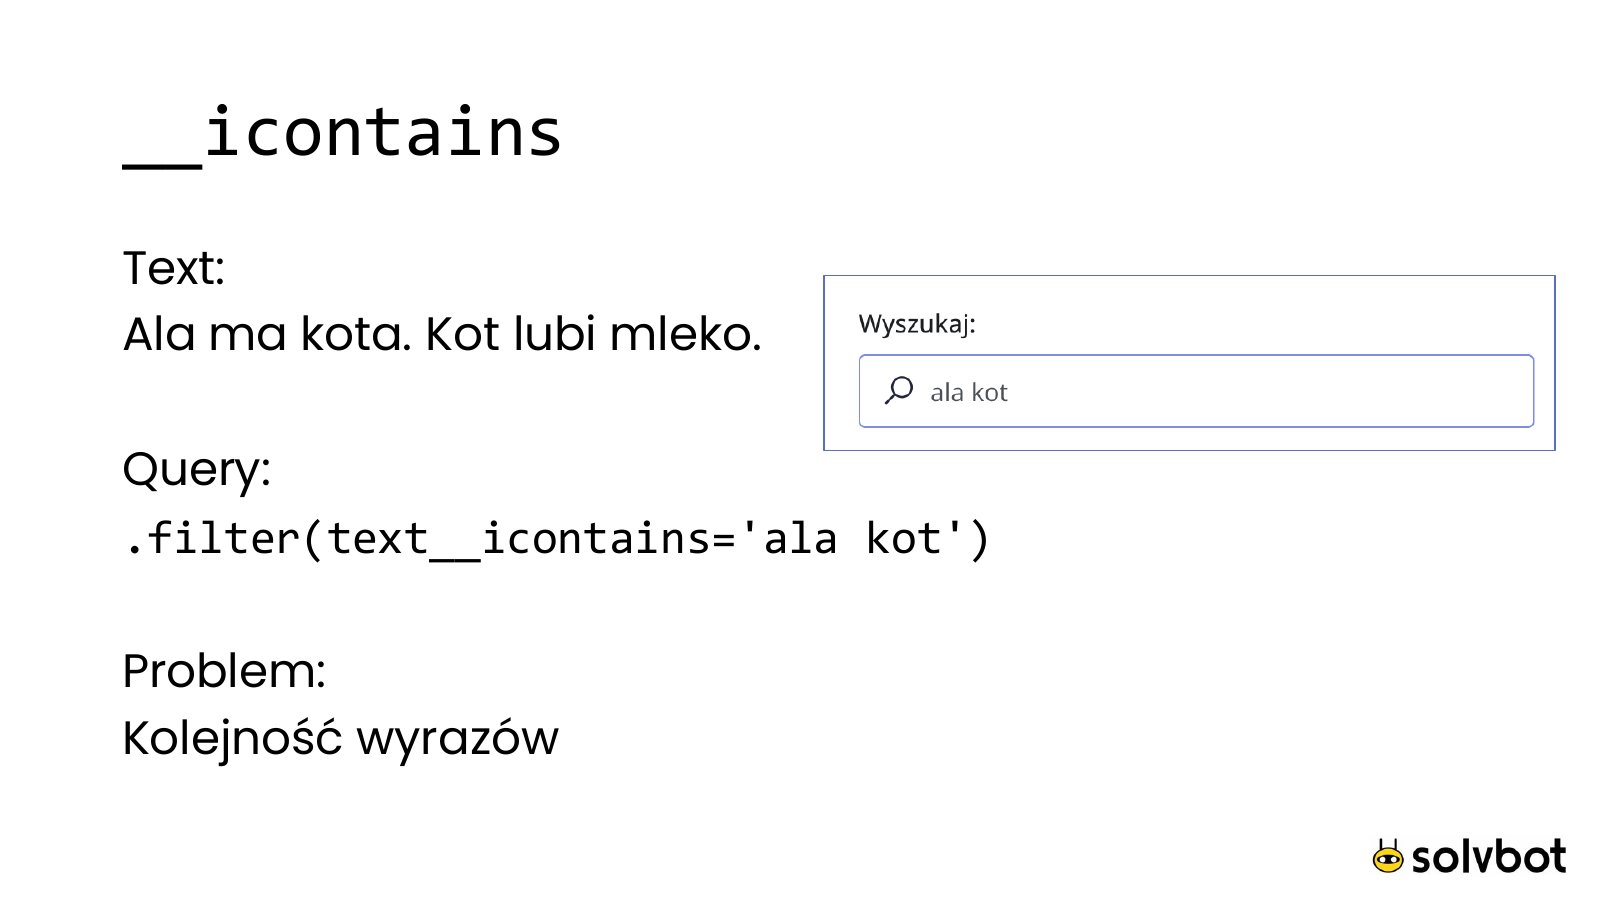
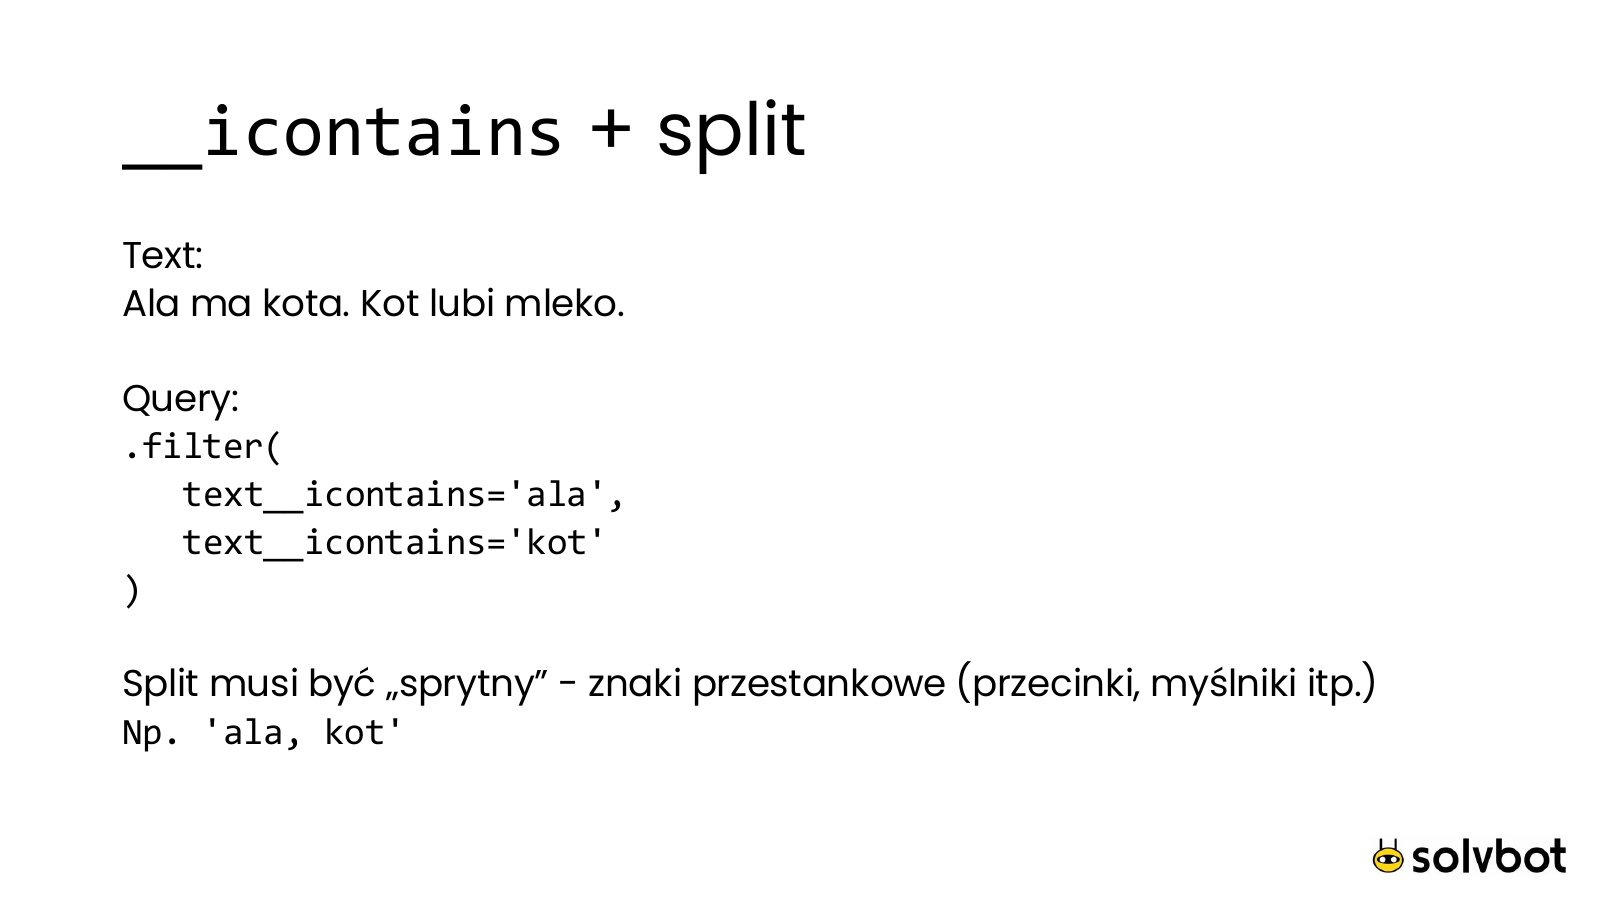
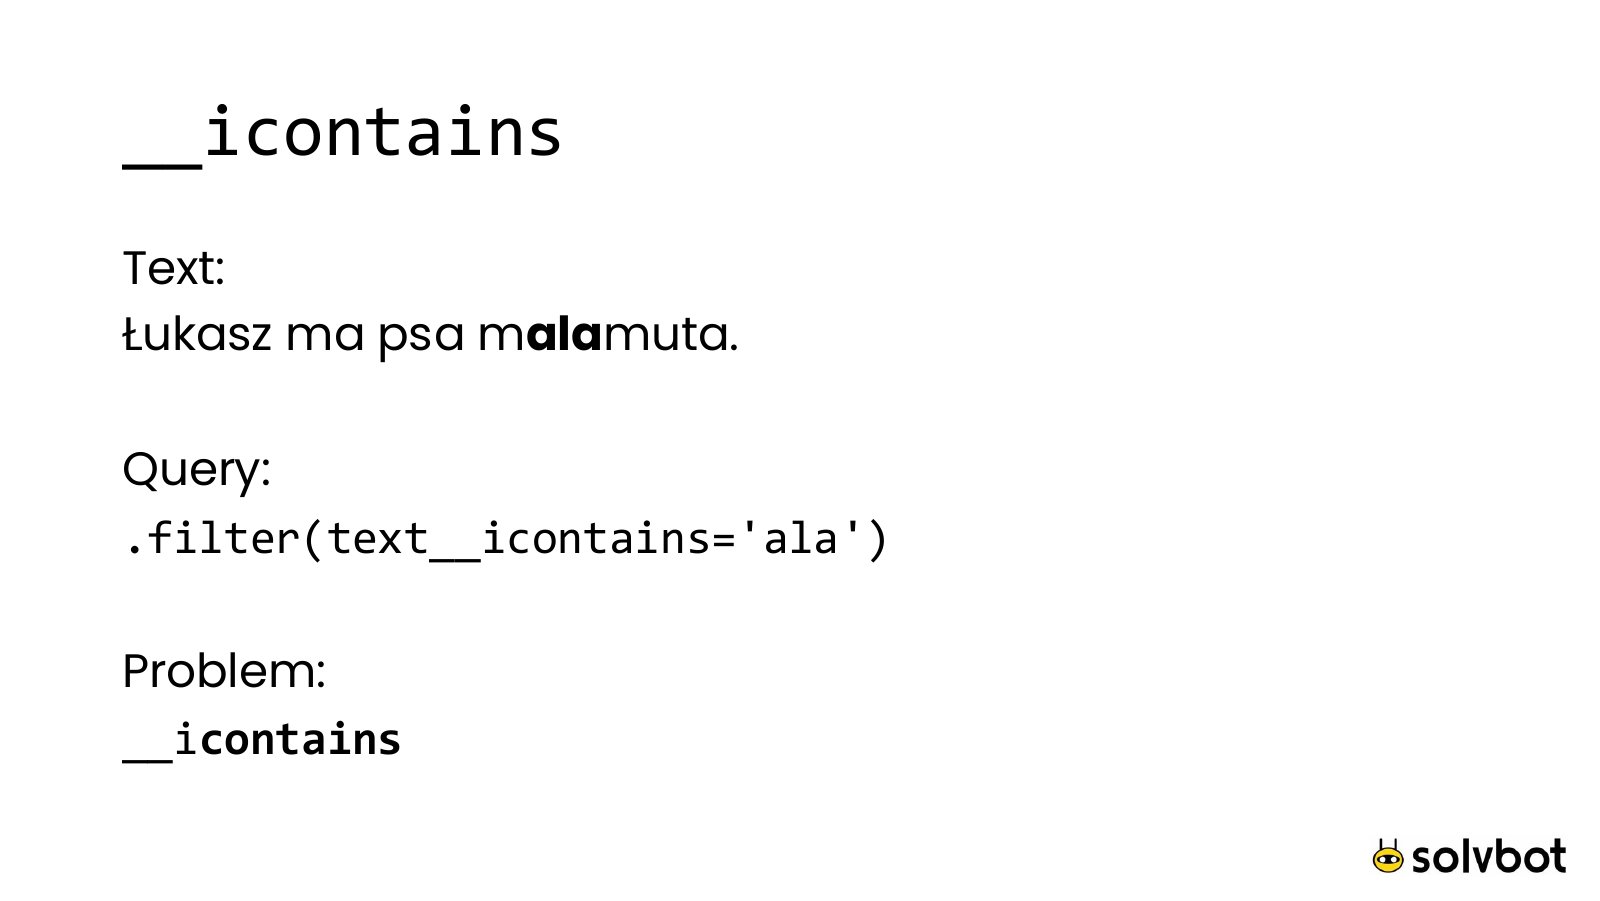
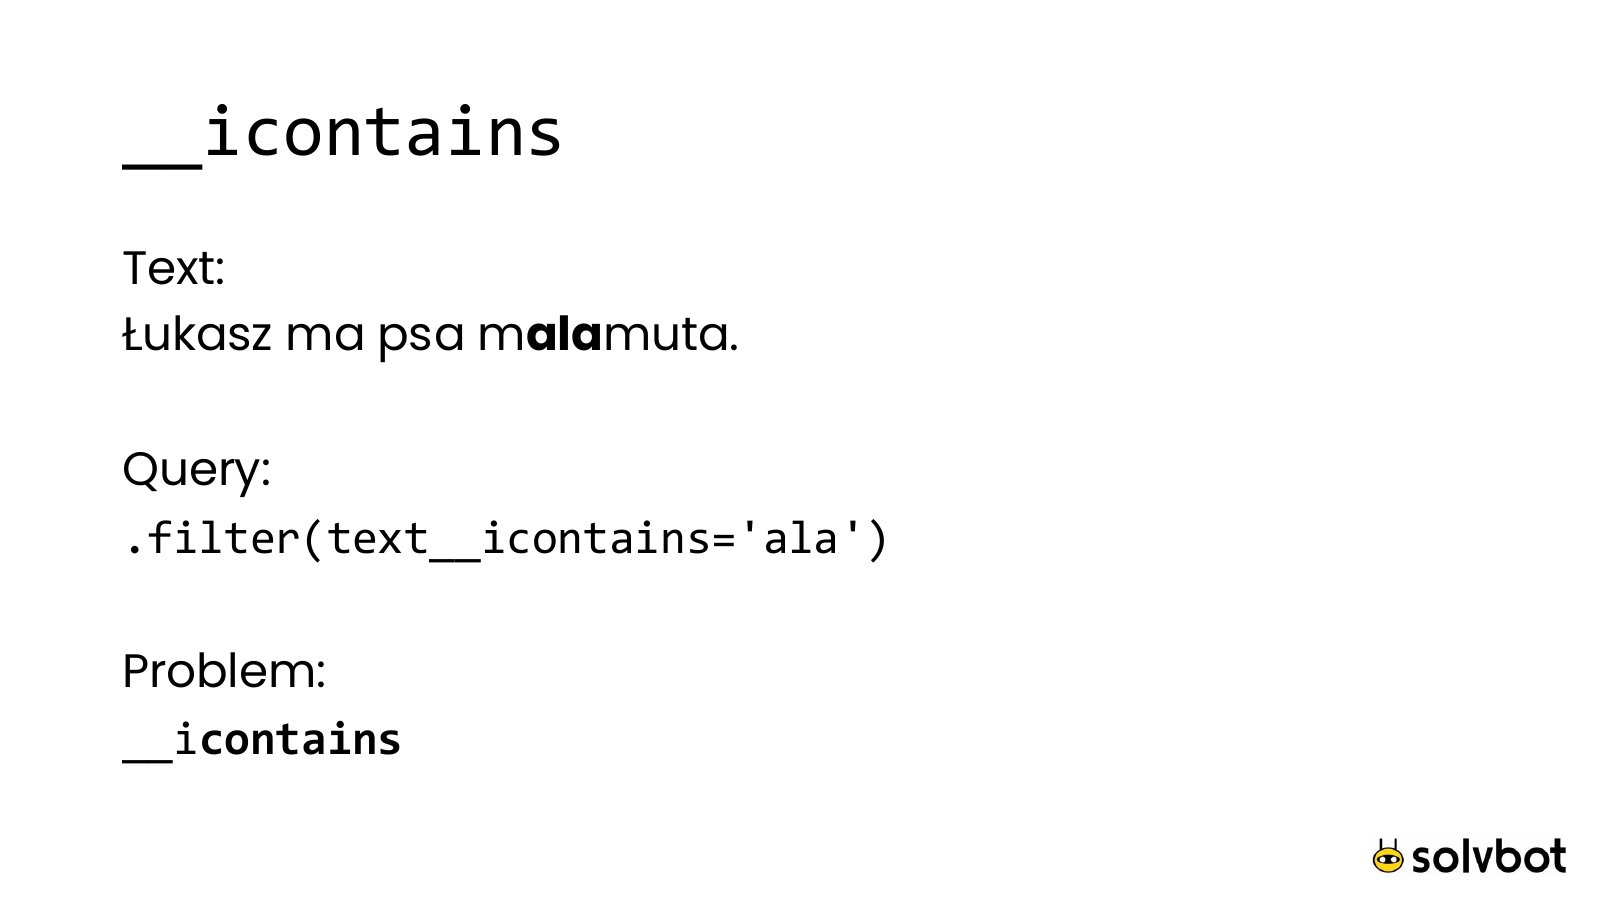
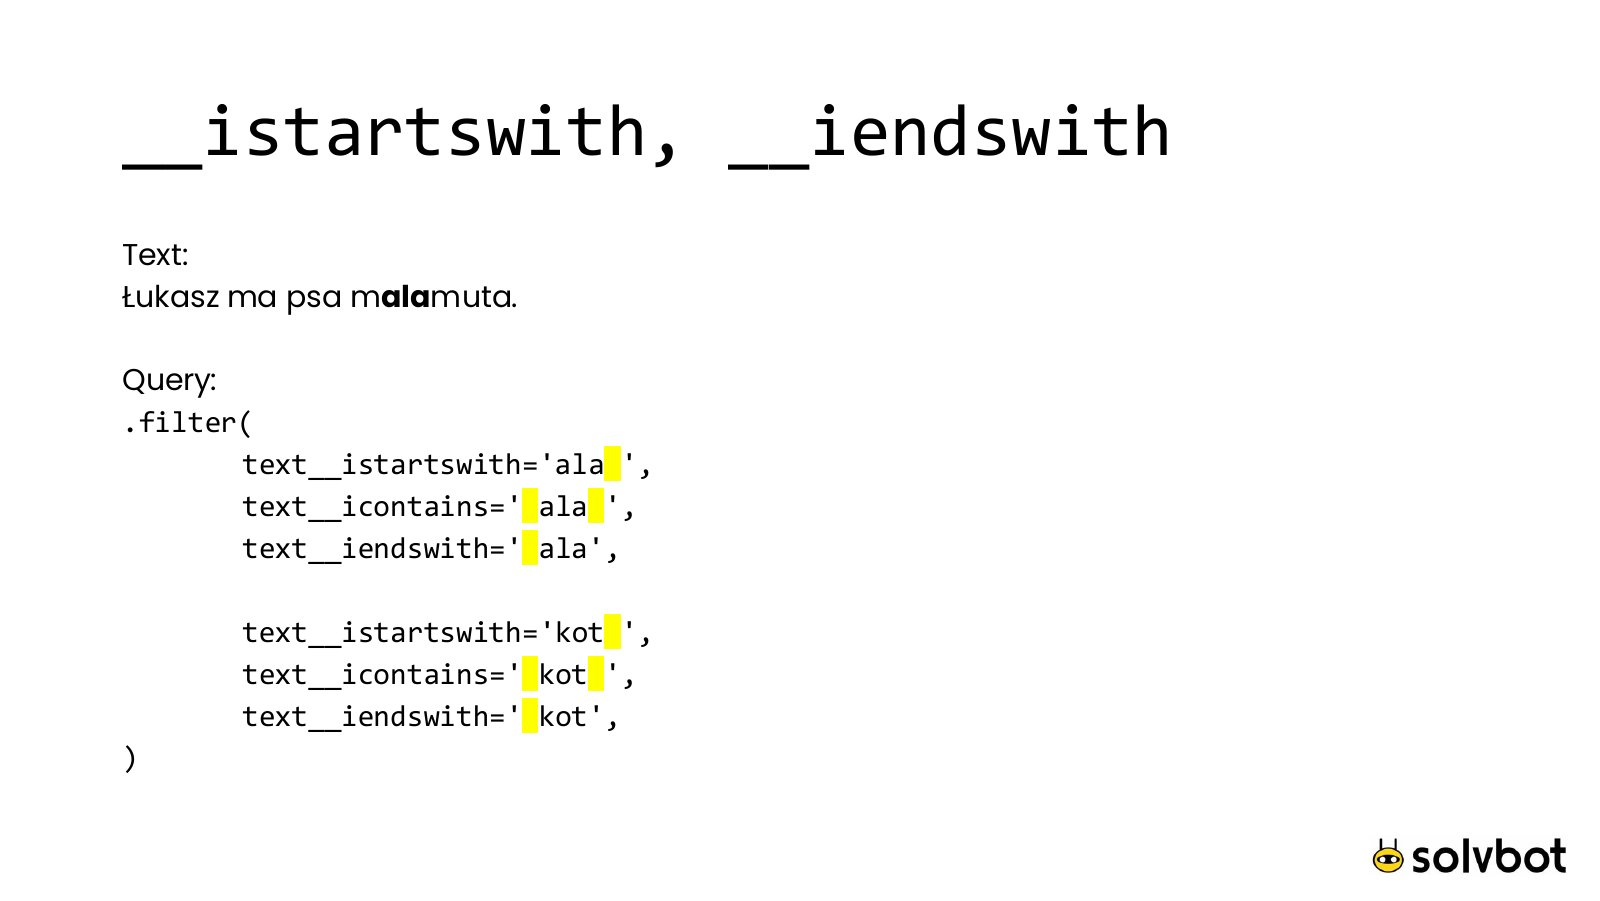
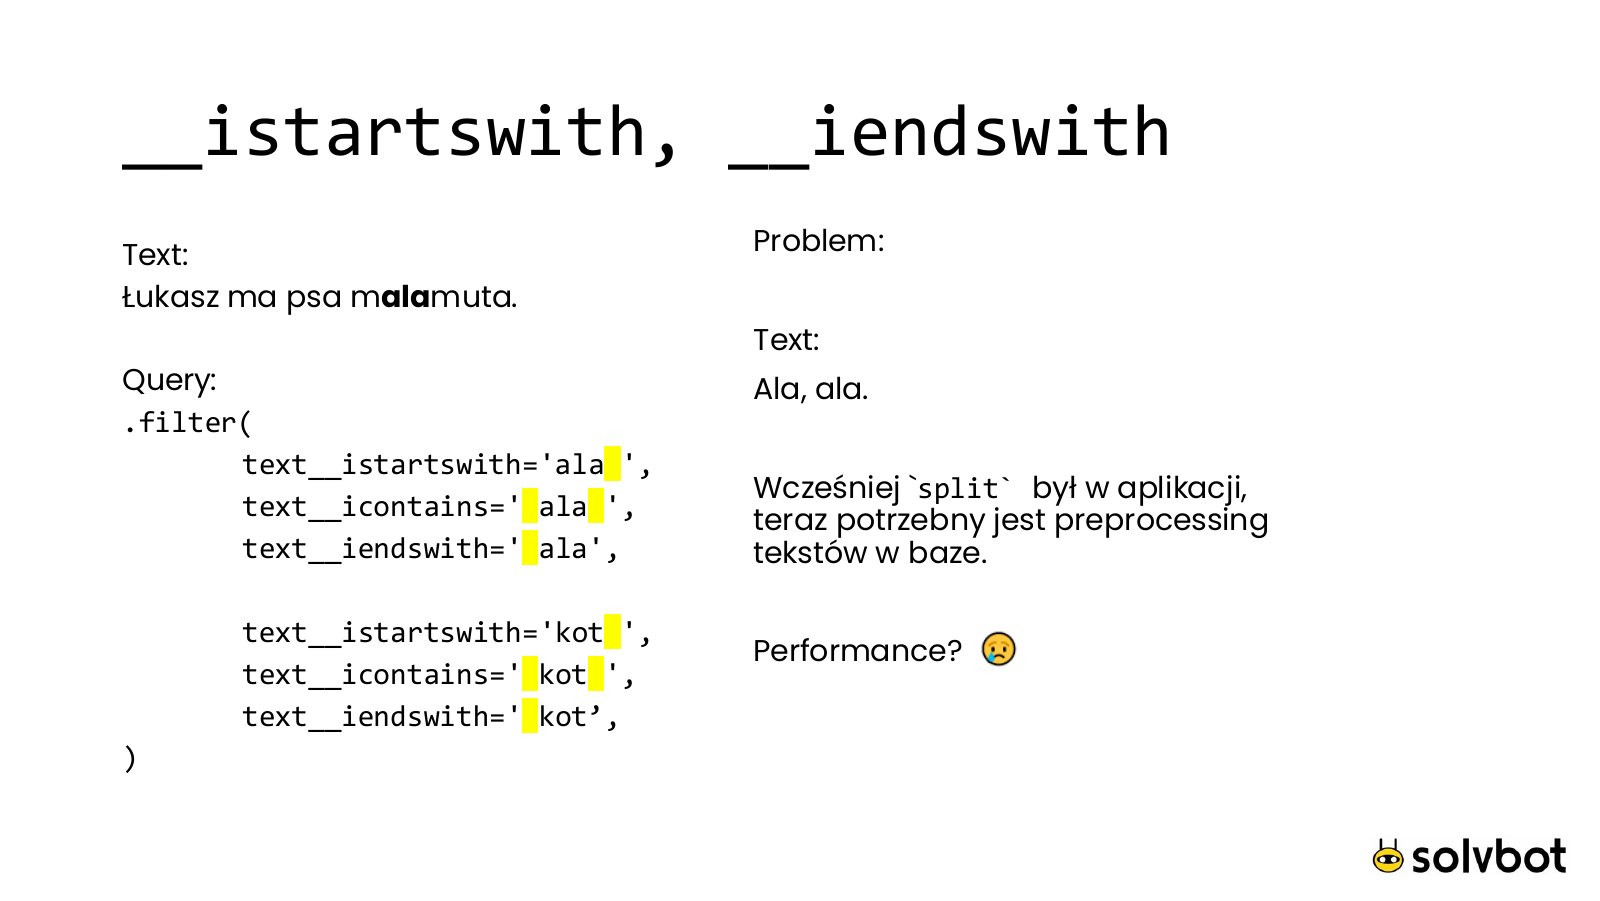
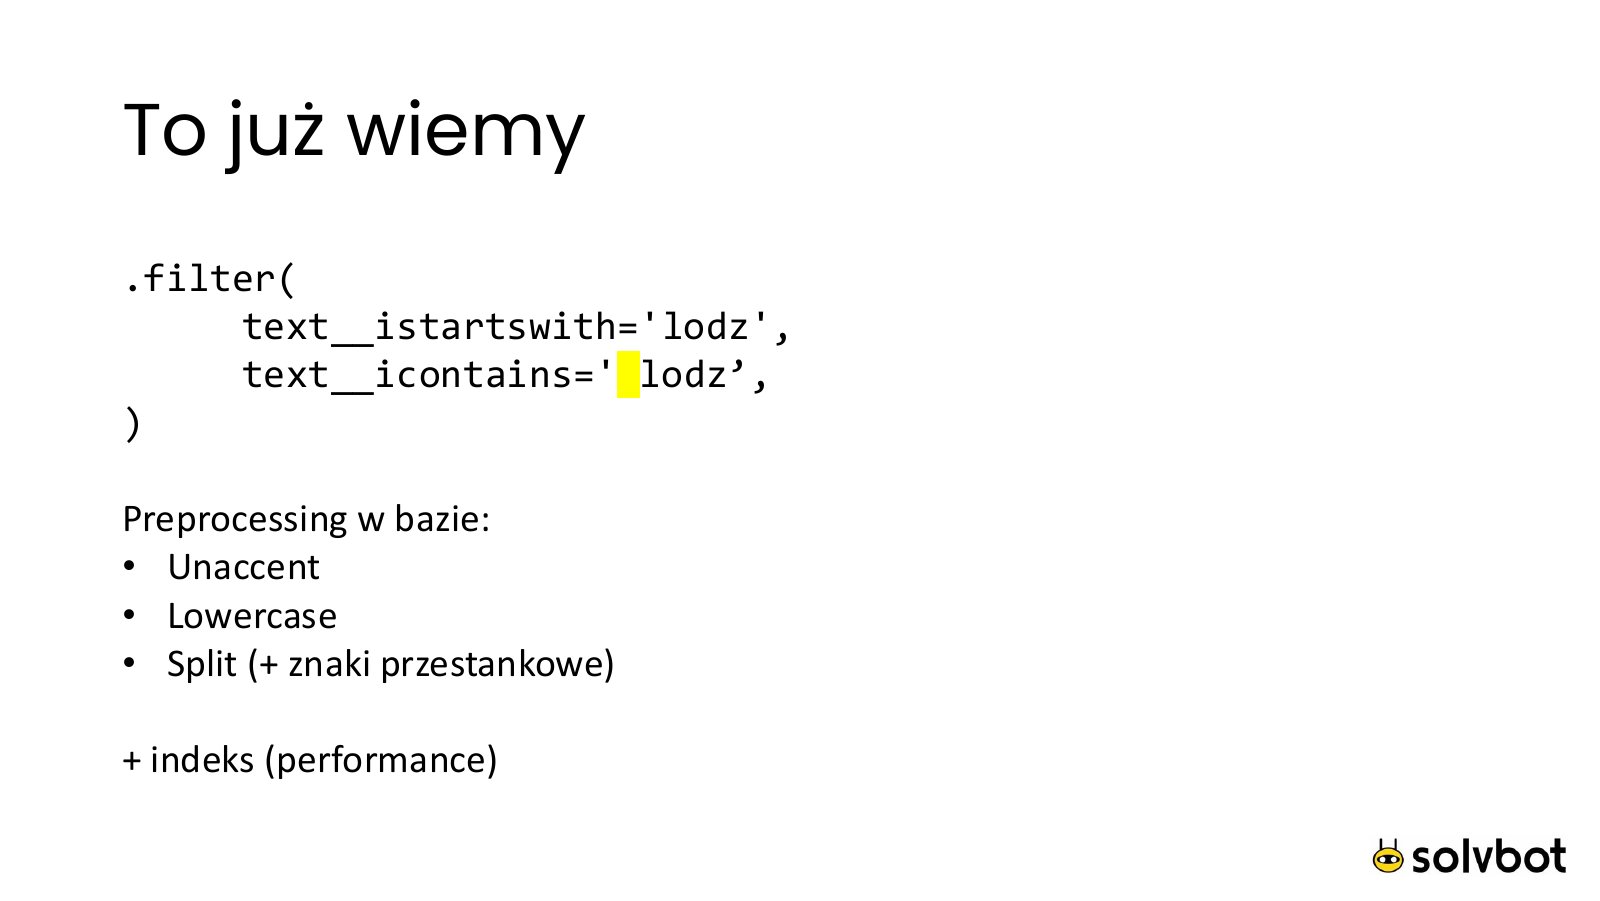
.filter(text__icontains="ala kot") nie znajdzie „Ala ma kota”, bo szuka dokładnie tego ciągu znaków, a słowa w tekście nie stoją obok siebie. Rozbicie zapytania na słowa pomaga, ale pojawiają się kolejne problemy:
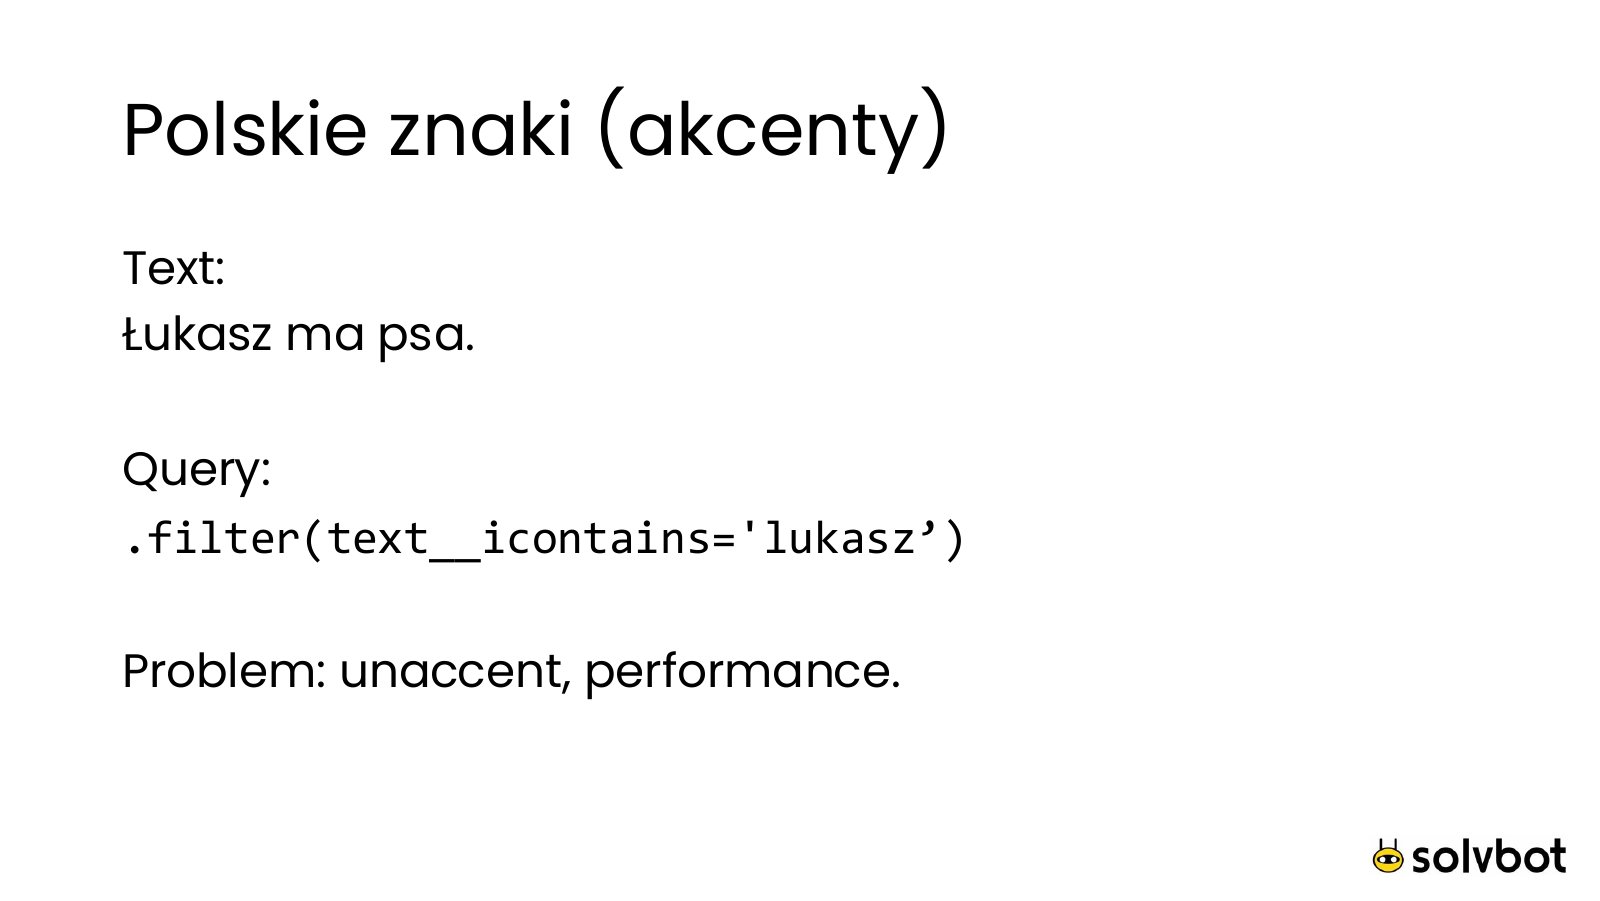
- polskie znaki: „lukasz” nie znajdzie „Łukasza” bez
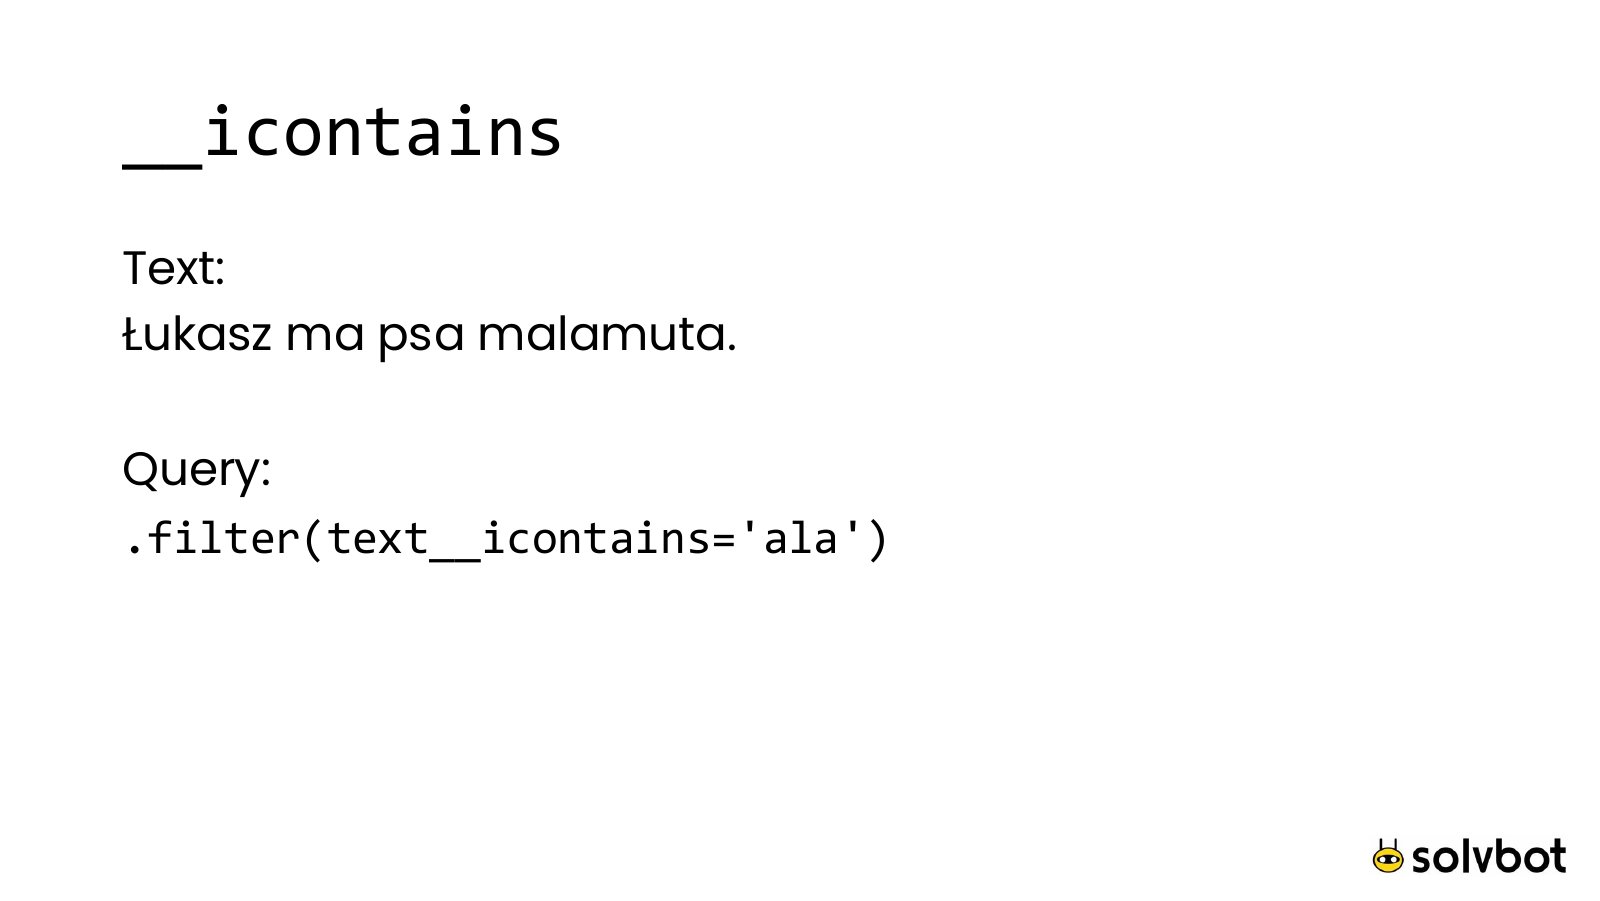
unaccent, - fragmenty słów: „ala” znajdzie „malamuta”,
- przecinki i myślniki, które trzeba sprytnie odciąć przy dzieleniu na słowa,
- wydajność, bo każde z tych obejść to pełny skan tabeli.
Wyszukiwanie pełnotekstowe? Nie tym razem
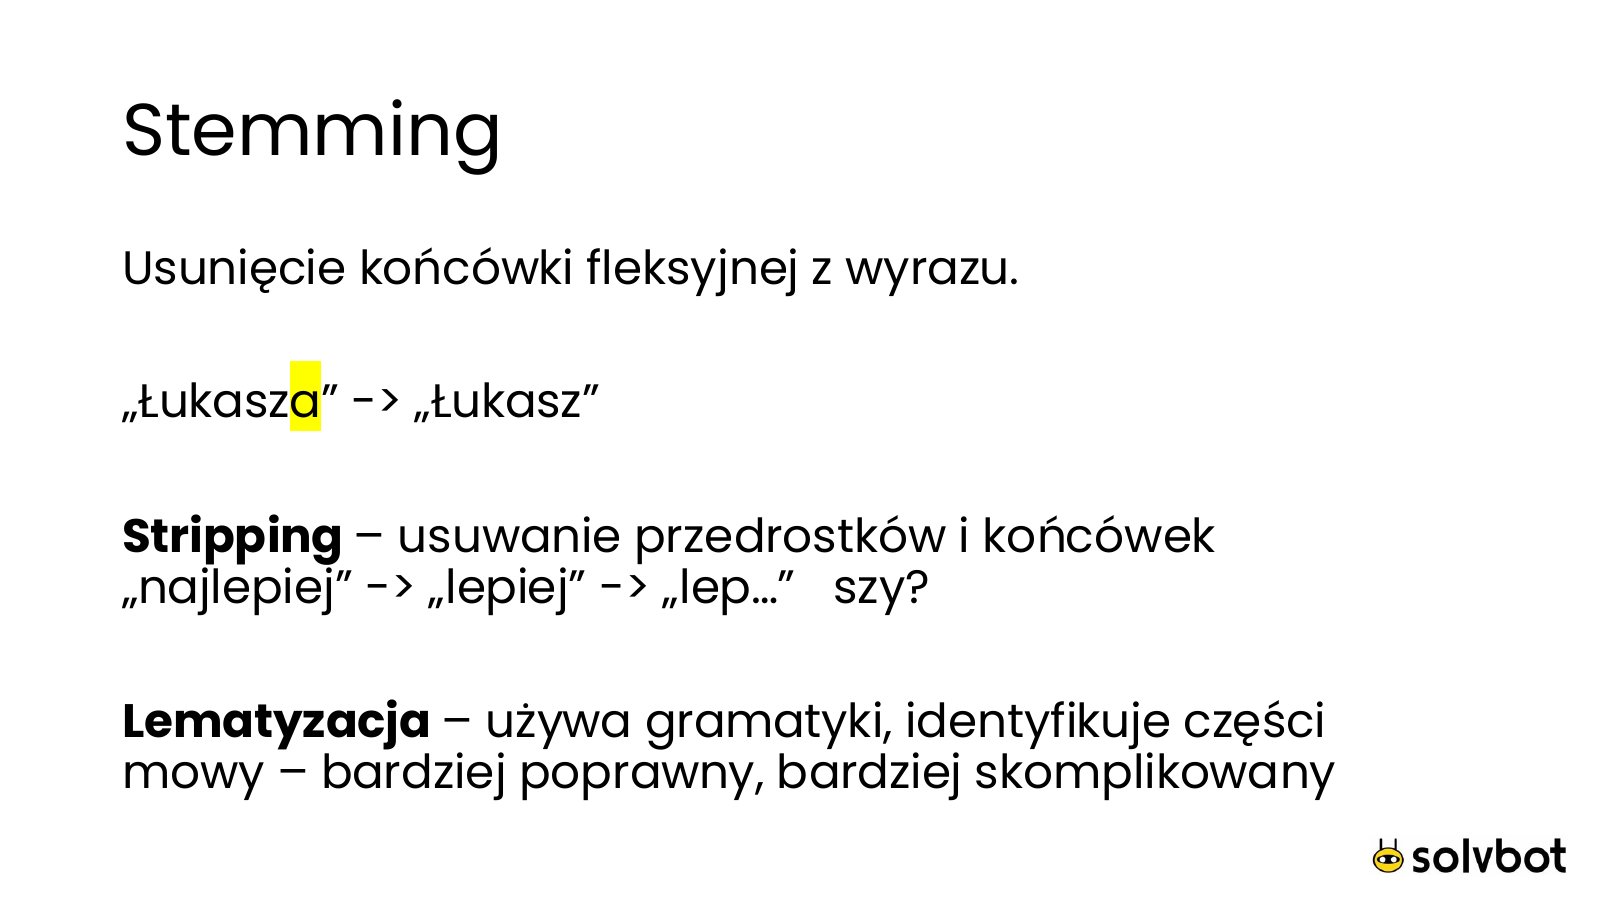
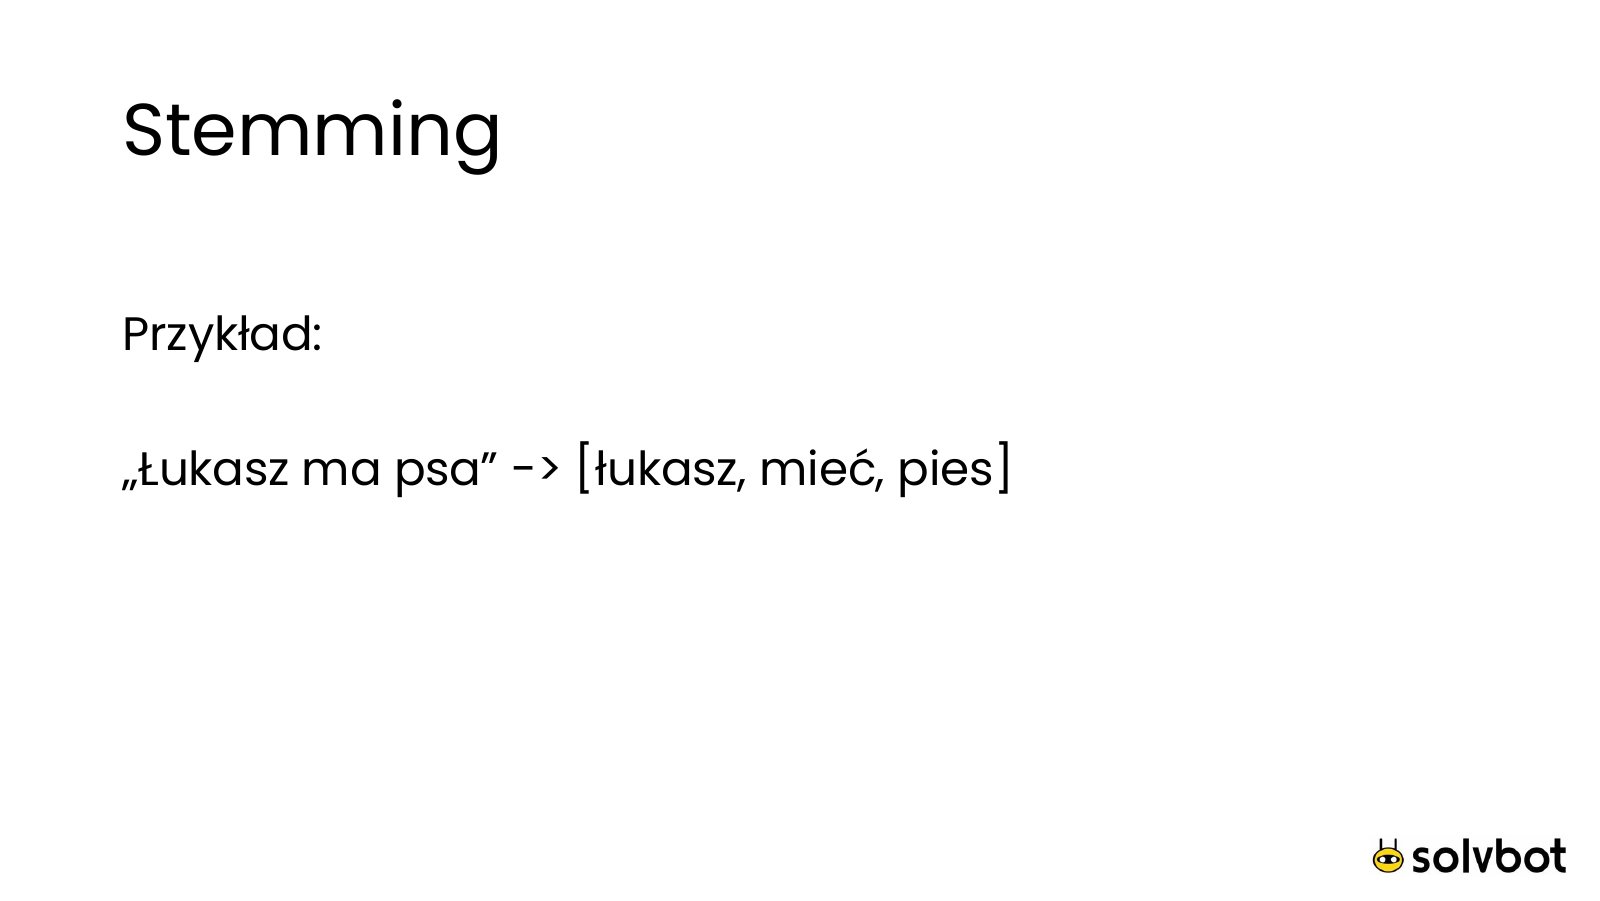
Prawdziwa wyszukiwarka to stemming i lematyzacja („Łukasz ma psa” → łukasz, mieć, pies), ranking wyników (TF-IDF), poprawianie literówek i narzędzia takie jak Lucene czy Elasticsearch. Do nazw sądów i tytułów gramatyka nie jest jednak potrzebna. Wystarczy szukać po początkach słów, bez polskich znaków i bez rozróżniania wielkości liter, byle szybko.
Trigramy i GIN w PostgreSQL
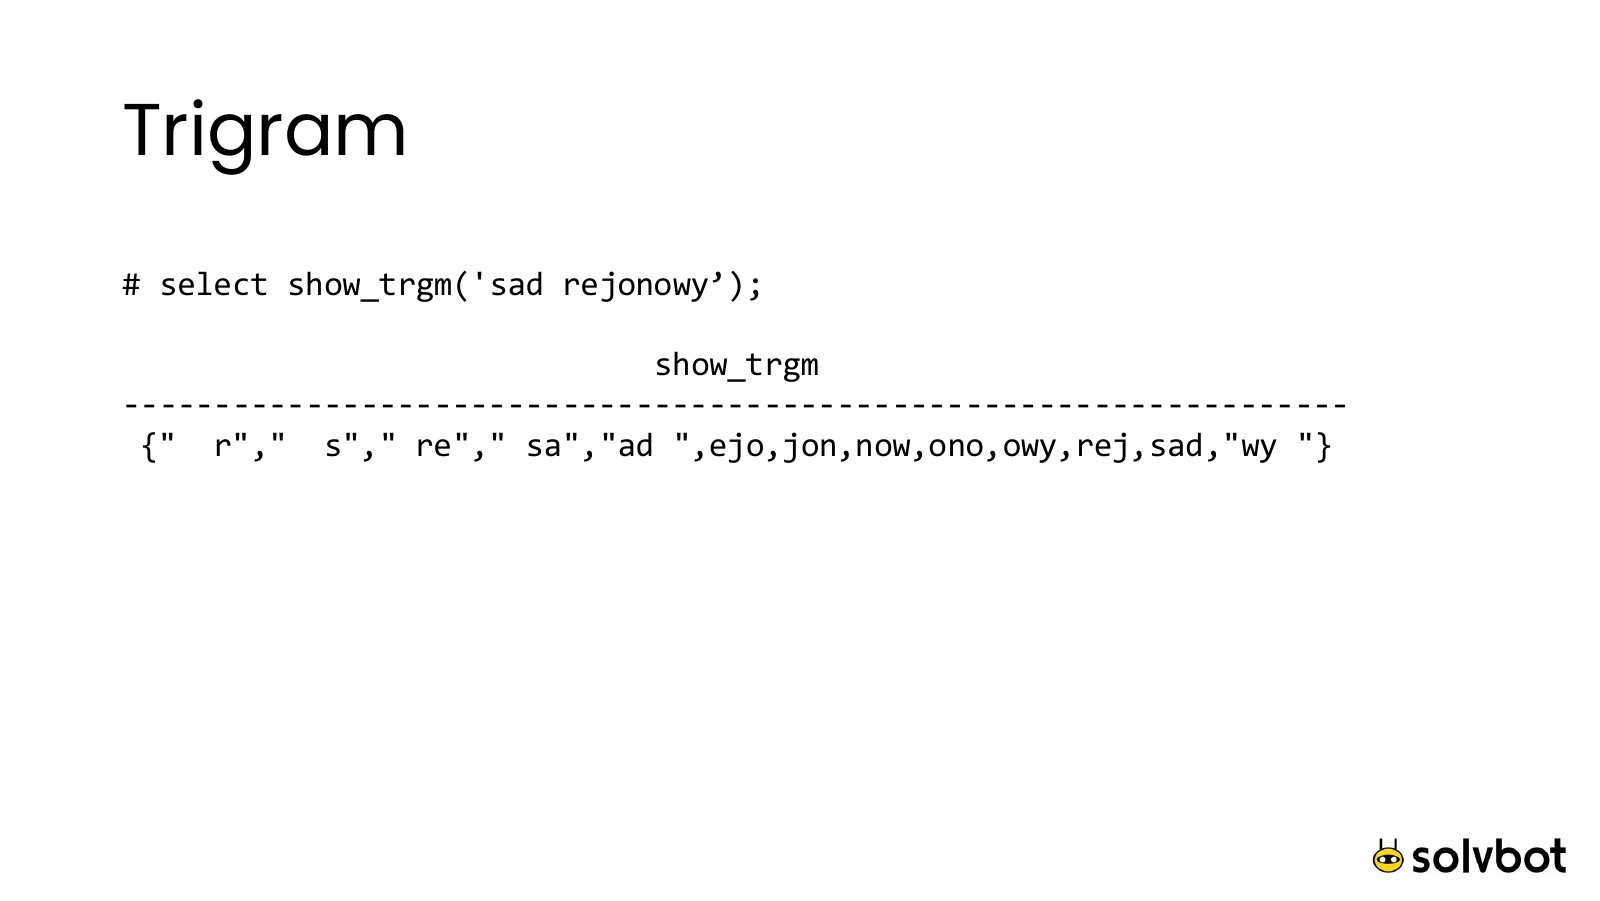
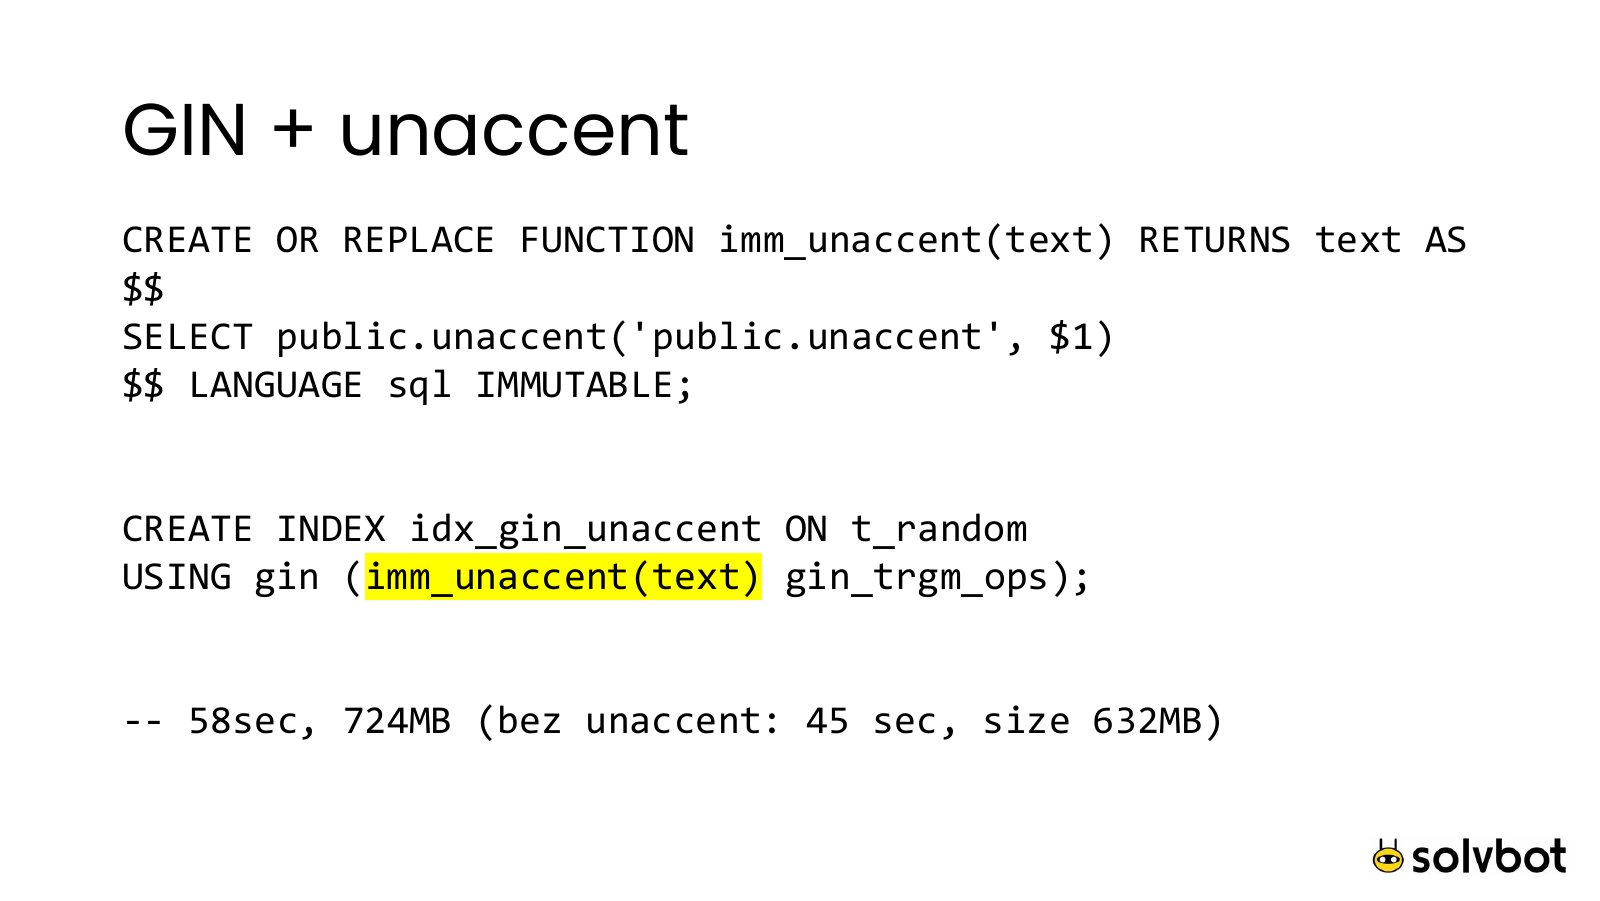
Rozszerzenie pg_trgm dzieli tekst na trójki znaków i pozwala indeksować zapytania ILIKE '%...%'. Haczyk: unaccent nie jest funkcją IMMUTABLE, więc nie da się go użyć w indeksie. Trzeba go opakować:
CREATE OR REPLACE FUNCTION imm_unaccent(text) RETURNS text AS $$
    SELECT public.unaccent('public.unaccent', $1)
$$ LANGUAGE sql IMMUTABLE;

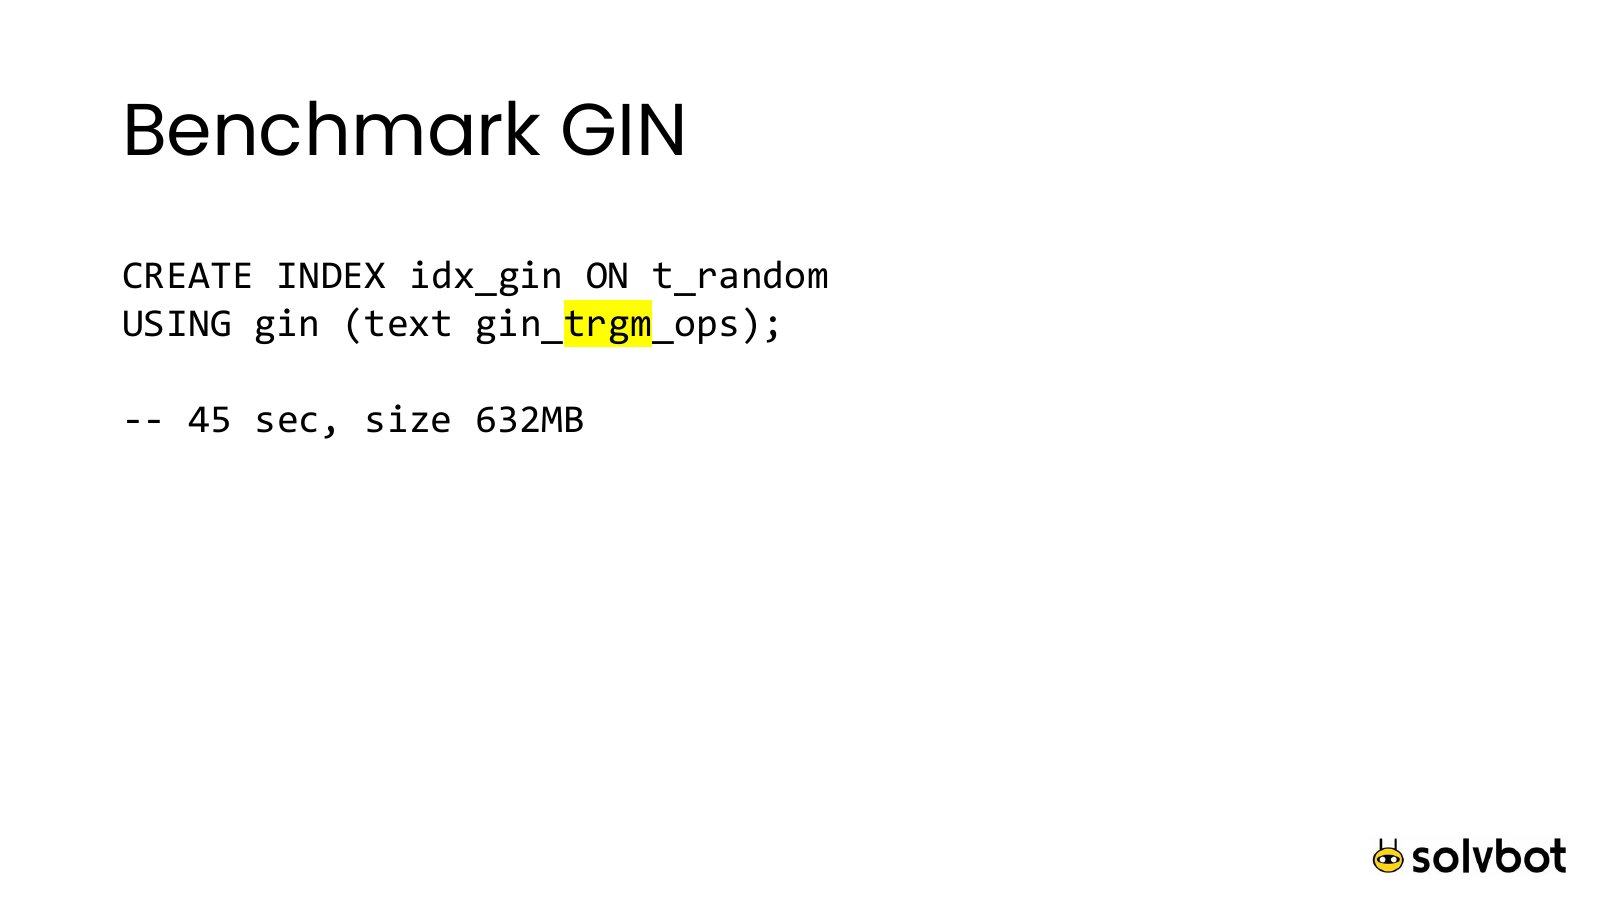
CREATE INDEX idx_gin_unaccent ON t_random
    USING gin (imm_unaccent(text) gin_trgm_ops);
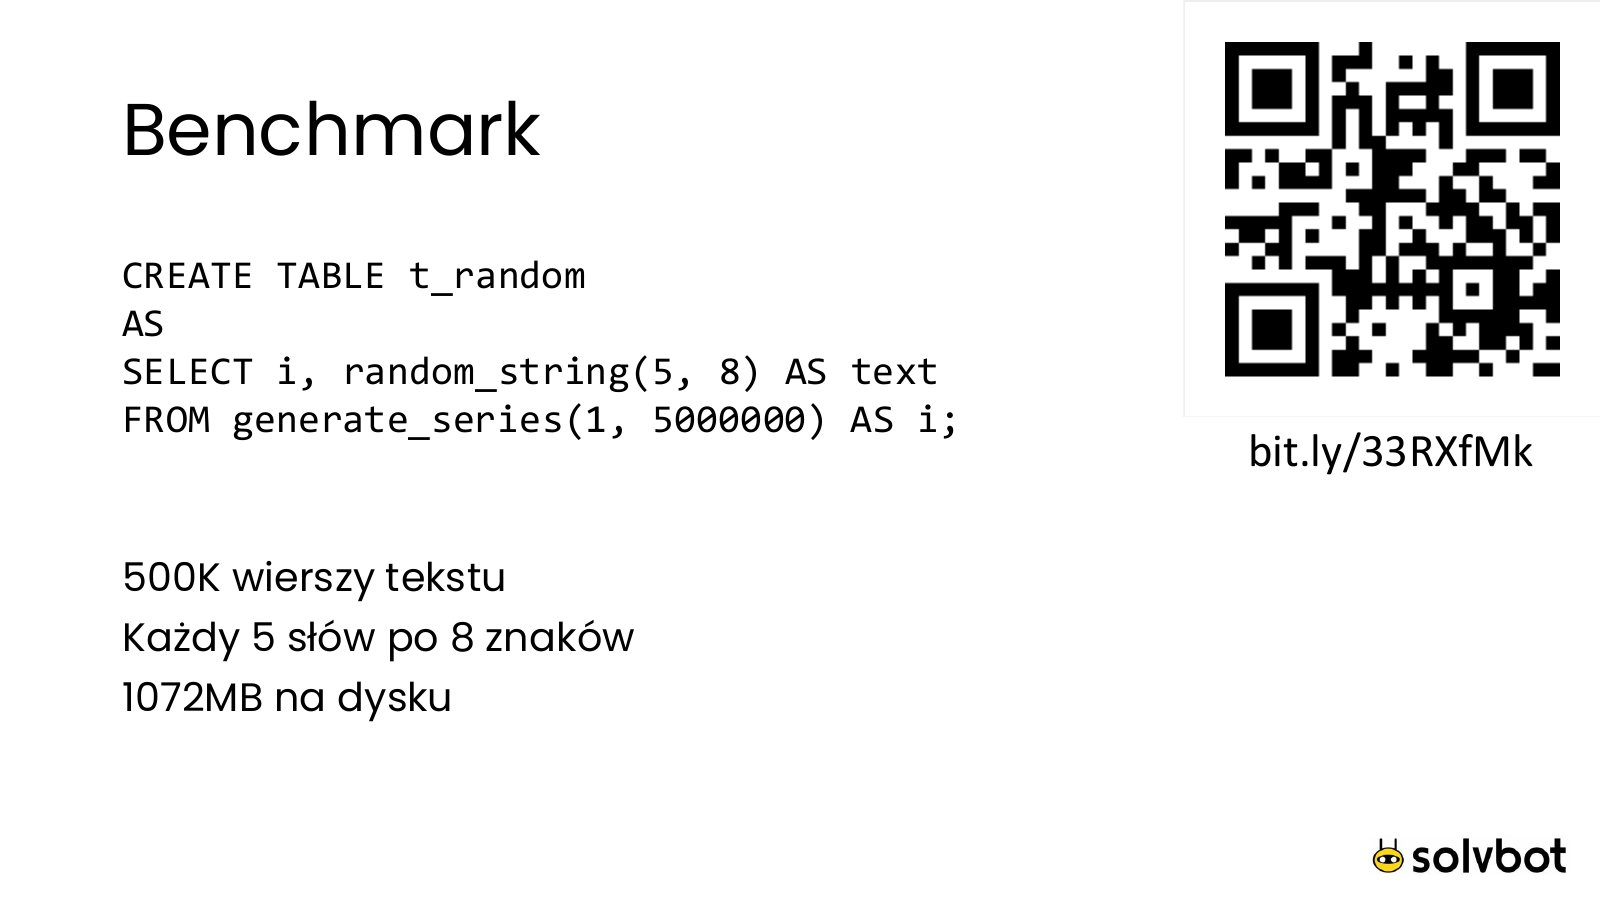
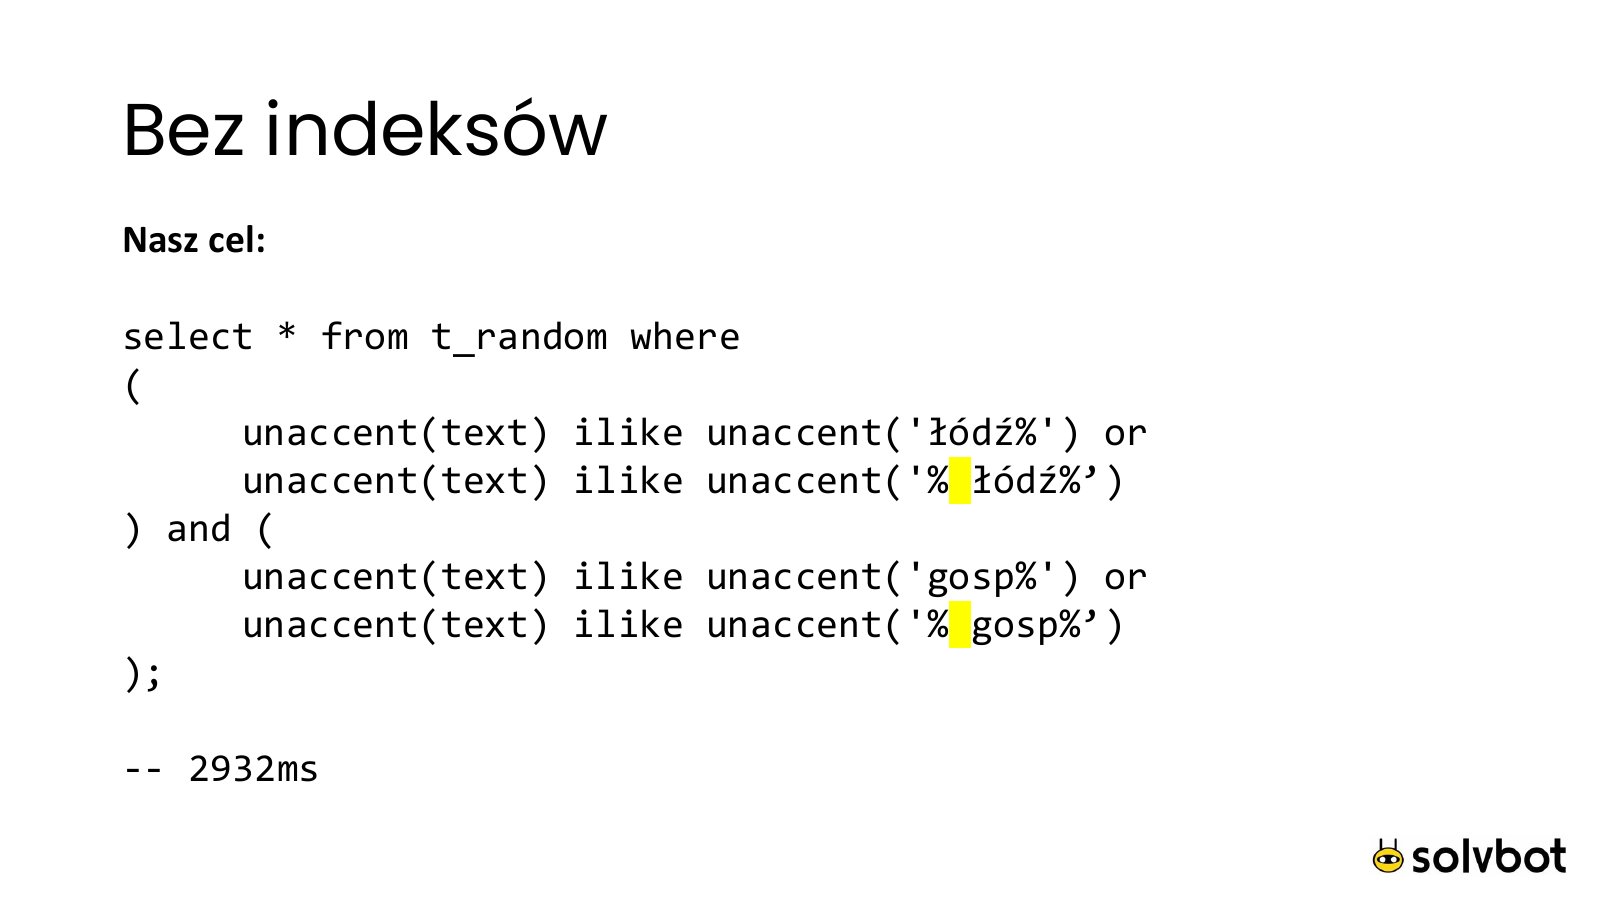
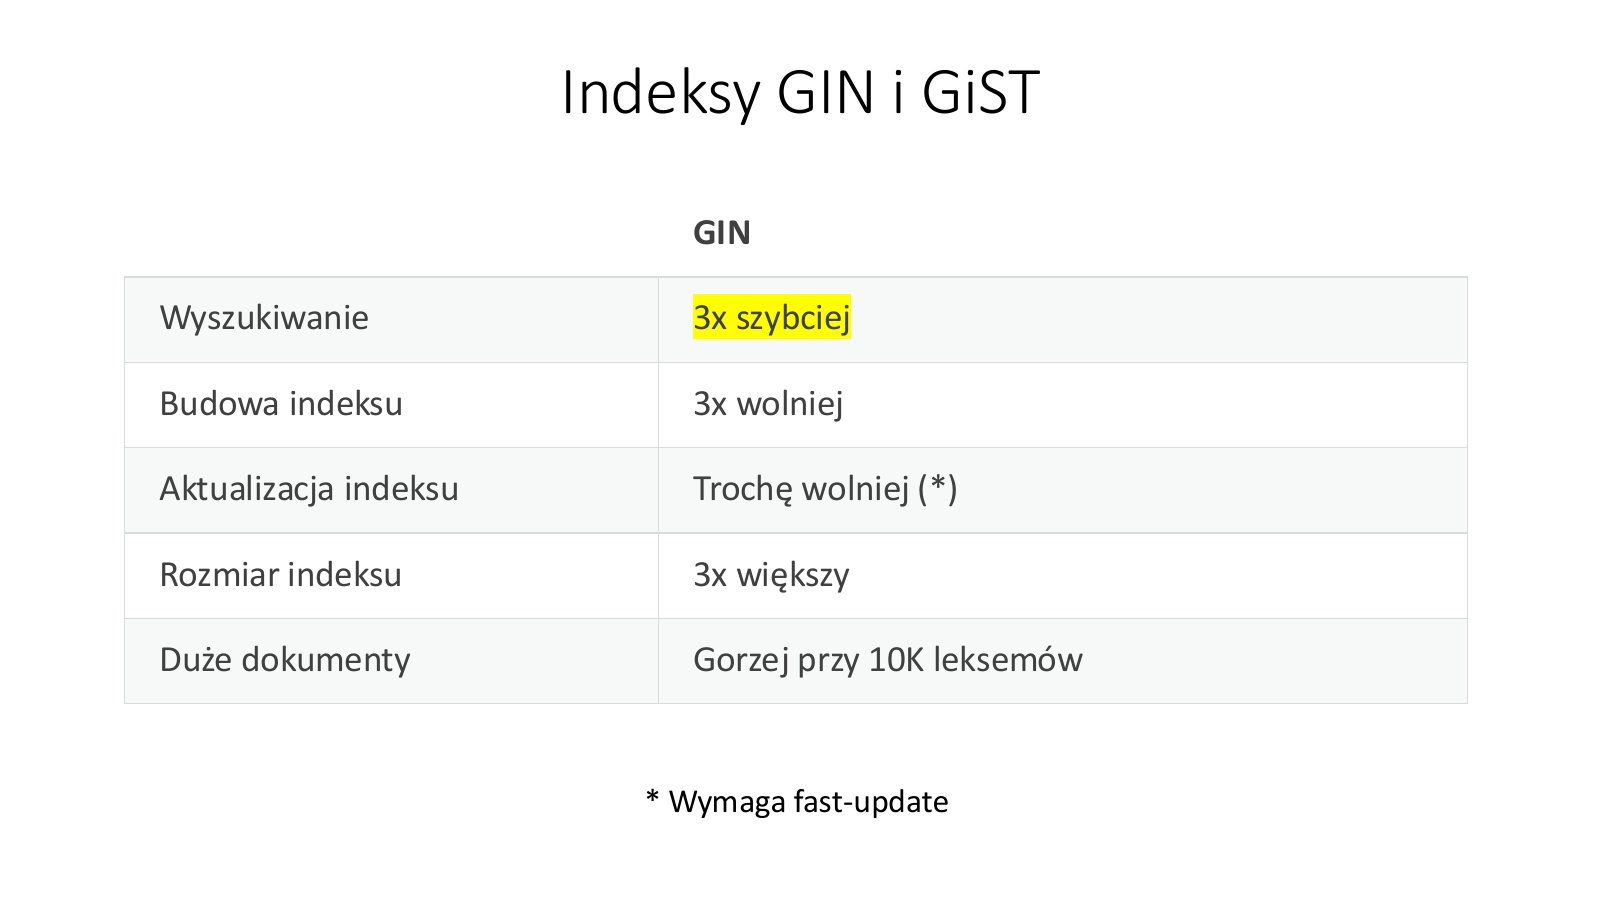
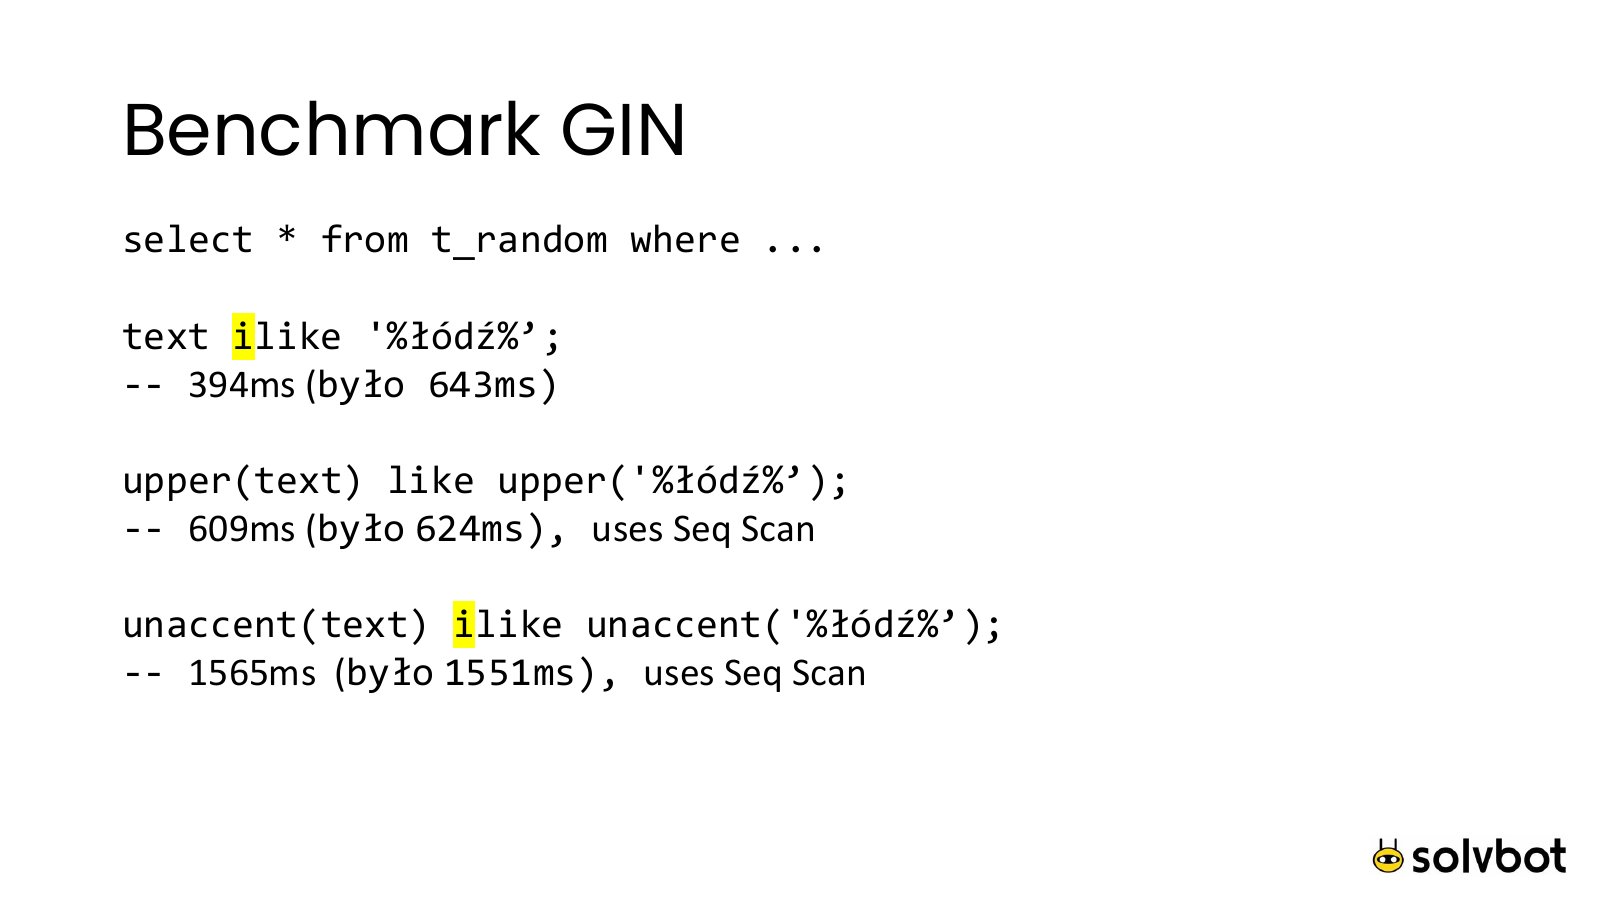
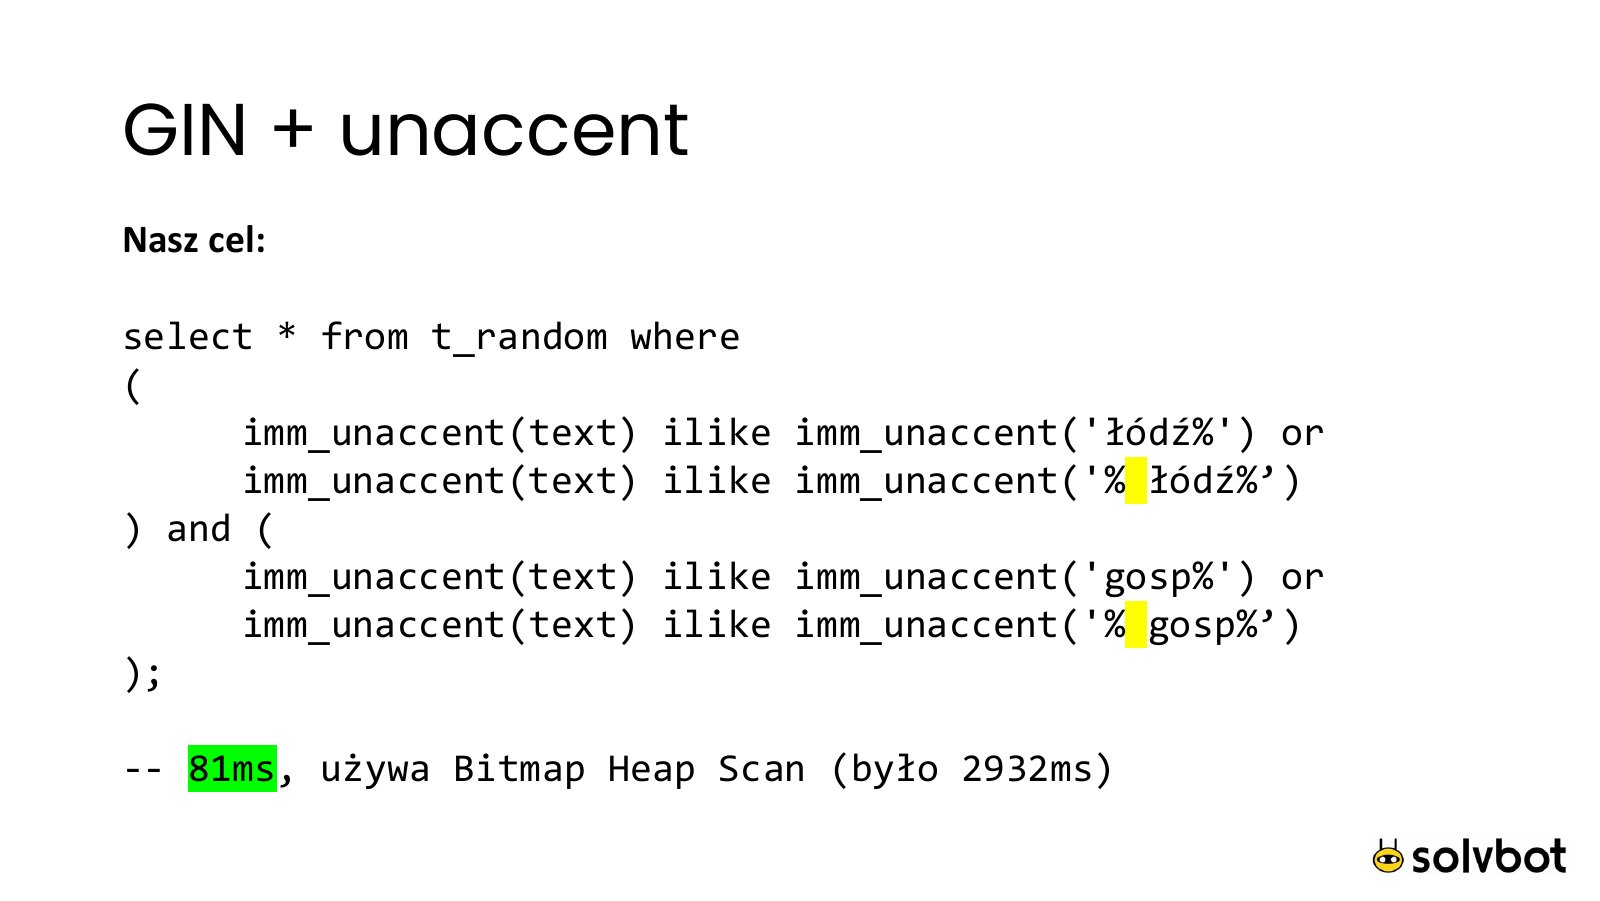
Benchmark na 5 mln losowych wierszy (po 5 słów, ok. 1 GB na dysku). Zapytanie docelowe to „łódź” i „gosp” jako początki słów:
| Wariant | Czas |
|---|---|
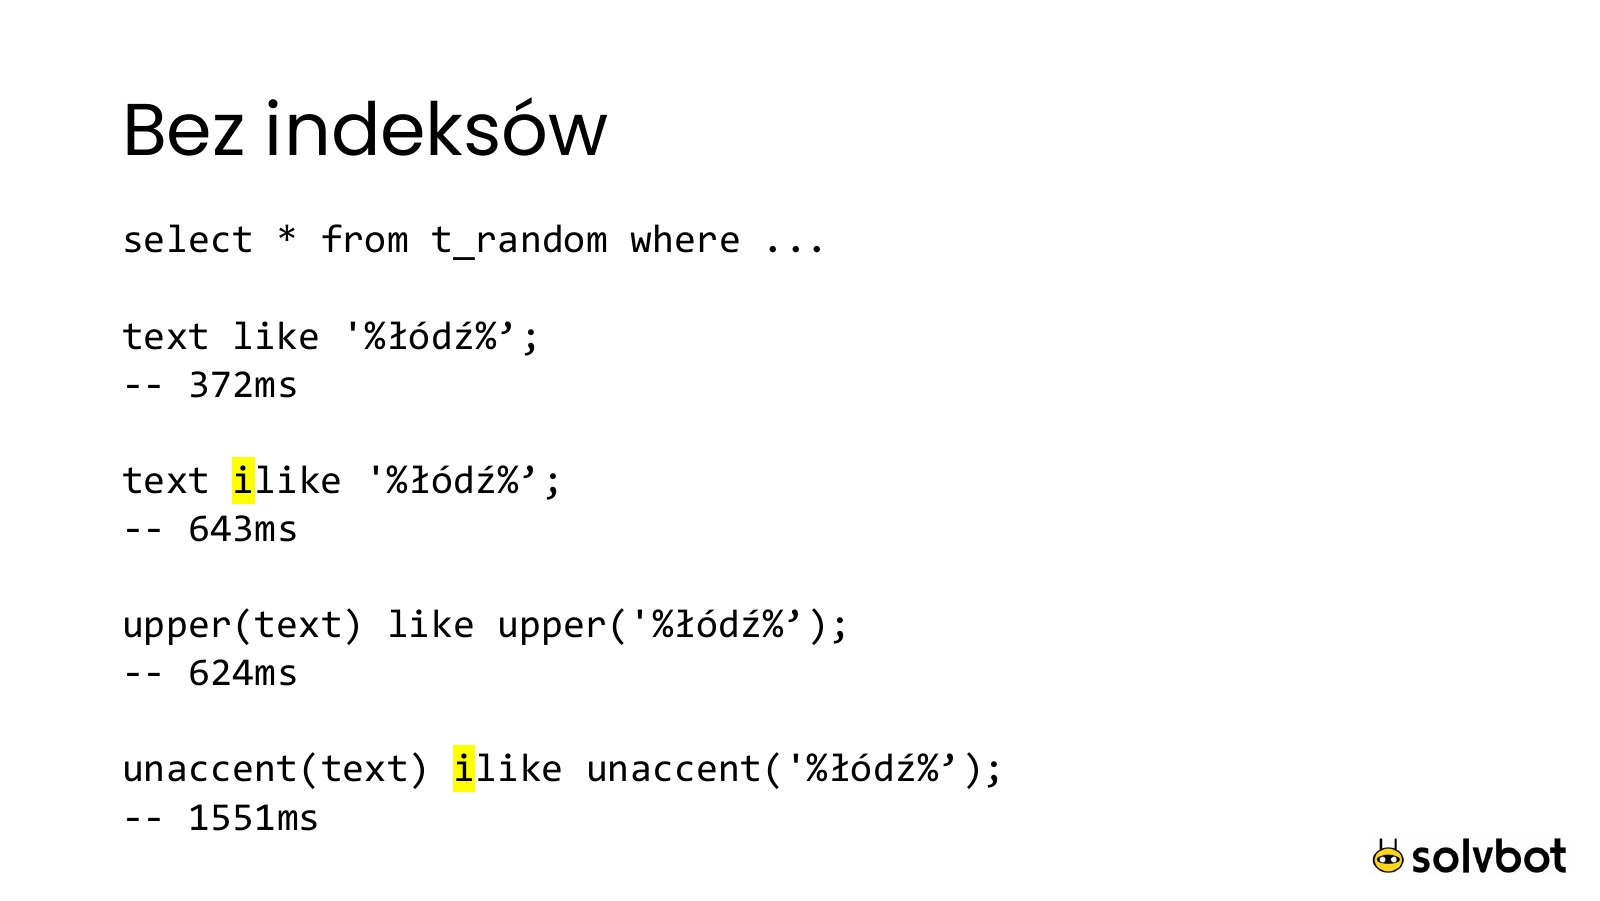
| Zapytanie docelowe, bez indeksu | 2932 ms |
Zapytanie docelowe, indeks GIN na imm_unaccent(text) |
81 ms |
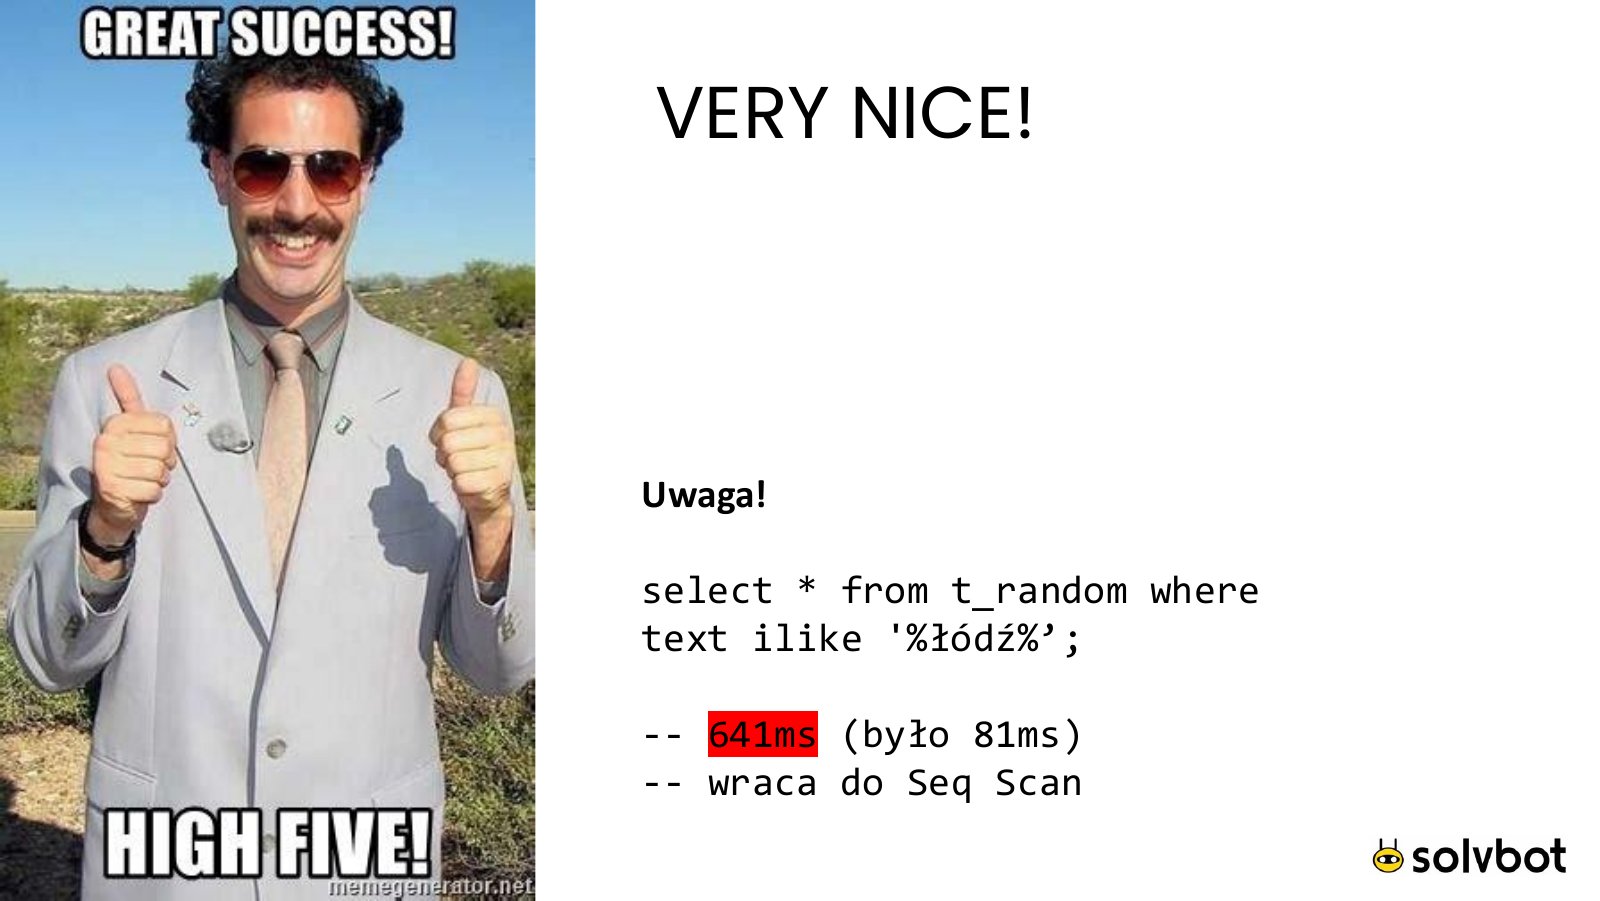
Proste text ILIKE '%łódź%' bez imm_unaccent, ten sam indeks |
641 ms |
Ostatni wiersz to pułapka: indeks działa tylko wtedy, gdy zapytanie używa dokładnie tego samego wyrażenia co indeks. Inaczej Postgres po cichu wraca do pełnego skanu.
Po stronie Django zostaje migracja, która włącza rozszerzenia pg_trgm i unaccent i tworzy funkcję imm_unaccent, oraz filtr budujący to zapytanie. To rozwiązanie działało u nas na produkcji od początku istnienia systemu.
Co dalej
Setki tysięcy dokumentów po kilka stron, w dużej części skanów po OCR. Tam proste dopasowanie już nie wystarczy i wracają stemming, ranking oraz literówki w nazwach własnych.
To samo wystąpienie powtórzyłem 17 maja 2022 na Pytech Summit (online).